
Последние посты

сбежавшая нейросеть
25 сент., 05:30
Сразу после выхода Claude Opus 5.5 во вторник я решил написать небольшой лонгрид о том, как Anthropic рекомендует промптить эту модель – и не догадывался, на какой гемморой подписался. В итоге за два дня плотной работы текст вырос до 40+ тысяч знаков – пожалуй, это самый подробный русскоязычный гайд по Opus 5.5:Уровень GPT-6 – и в разы дешевле. Самый подробный гайд по Claude Opus 5.5Из текста вы узнаете:— как правильно промптить эту модель, что добавить в пользовательские инструкции и CLAUDE.md (а что – убрать). — какой режим рассуждений использовать, чтобы не прогореть по токенам (я проверил на 48 прогонах). — как создавать нашумевшие JavaScript-ролики и озвучивать их с помощью Gemini 3.8 Flash TTS или локальной модели. Идеально для учебы, рекламы, маркетинга и многого другого. — как рисовать 3D-сцены в Blender, работать с графиками, презентациями и многое другое.А бонусом расскажу вам историю, как Opus 5.5 написал пост на этот канал, а вы поставили ему больше лайков, чем мне.Это невероятная модель, при работе с которой у меня появляются новые идеи чуть ли не каждый час. Но текст подойдет не только тем, кто работает с Opus 5.5 – многие описанные трюки подходят и для GPT-6 Astra. Так что бегом читать:— Читать на “Бусти” — Читать на Sponsr

сбежавшая нейросеть
24 сент., 17:26
— Так как на второй день существования Opus 5.5 уже мало кого удивишь роликами, сделанными в JavsScrypt и HTML, то чуточку усложнил задачу. Claude Code сходил к Codex, тот ему нагенерил картинок в ChatGPT Images 2.5, а затем Opus 5.5 собрал коллажную анимацию в стиле раннего Терри Гиллиама.— Кстати, идею взять стиль Гиллиама тоже предложил Opus 5.5. С моей стороны постановка задачи звучала примерно так: “что-то скучно стало, давай проверим, сможешь ли ты заказать через Codex генерацию картинок, а затем придумай, как это использовать в ролике”. Модель дала сразу пять идей, я выбрал нужную, очень устал от такого творческого напряжения.— Еще этот чертяка рисует в Blender как минимум на уровне GPT-6 Astra, а может и лучше. Но копается дольше.— Мне очень интересно, что станет со специализированными моделями генерации видео и картинок на фоне этого безобразия. Opus 5.5 и GPT-6 фактически научились рисовать кодом, а дальше с каждой версией будут делать это лучше и лучше. Полагаю, что для создания реалистичных изображений останутся специализированные модели, а вот художественные картинки и анимации будут рисовать уже LLM.— В сети народ вытворяет с помощью Opus 5.5 ну просто все, что в голову придет. Превращает картинки в небольшие видеоигры, делает интерактивные справочники, трехмерные сцены в Three.js и далее, далее. У меня самого Claude Code сейчас запущен в несколько параллельных сессий – столько всего хочется попробовать.— При этом модель очень экономичная. Если на 100-долларовой ChatGPT Pro я прямо вижу, как GPT-6 Astra высасывает лимиты на некоторых задачах, то Opus 5.5 на 100-долларовой Claude Max гонял сегодня весь день, зачастую в несколько паралелльных агентов, и потратил 11% от недельного лимита всего.Финальные выводы пока не готов делать, но в целом мне очень нравится, какими получились Claude Opus 5.5 и GPT-6 Astra. И даже есть ощущение, что меня ограничивают не возможности ИИ, а наличие новых идей. Появилась идея, скинул в модель – она разложила, как это можно сделать. Фантастика.— Опытом использования ИИ делюсь на “Бусти”, там уже 30+ крутых лонгридов про модели и агенты, так что самое время подписаться!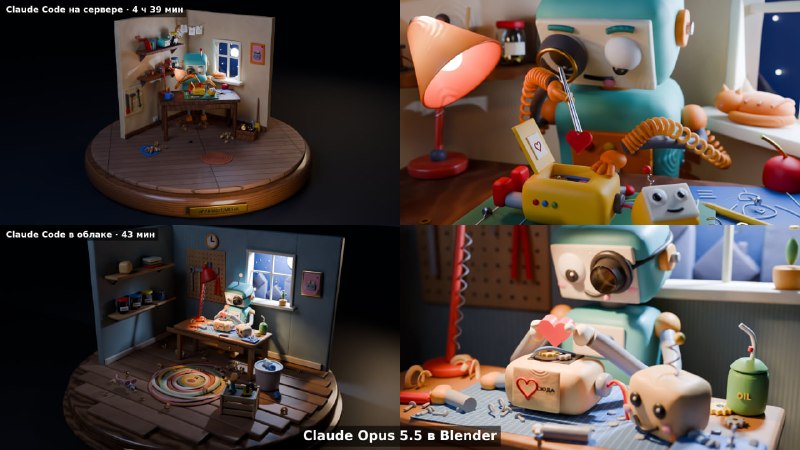

сбежавшая нейросеть pinned «Сегодня освежил все свои гайды по промптингу, убрал устаревшие приемы, добавил ставшее актуальным на конец лета 2026 года. Окинул еще раз взглядом проделанное и понял, что получился мини-курс, полезный и для новичков, и для тех, кто уже давно работает с ИИ.…»
24 сент., 17:26
сбежавшая нейросеть
24 сент., 09:58
Anthropic обвинила DeepSeek и Moonshot в подмене ответов своих моделей на ответы Claude. Теперь у китайских разработчиков проблемы – и проблемы с неожиданной стороны.Про сам отчет Anthropic я уже рассказывал: в нем компания обвинила семь разработчиков ИИ из Китая в дистилляции – массовом выкачивании ответов Claude, чтобы учить на них собственные модели. Но у этой истории появилось продолжение – в Пекине.По данным The Information, Управление по вопросам киберпространства Китая (CAC) сначала вызвало представителей всех семи компаний, а затем сосредоточилось на DeepSeek и Moonshot (разработчик Kimi). Чиновники уже приходили в обе компании и опрашивали руководство и сотрудников. Проверка идет, решения о санкциях нет, компании молчат. Для Moonshot это уже болезненно: она конфиденциально подала на IPO в Гонконге примерно на $3 млрд, и открытую проверку регулятора придется раскрывать в проспекте.Вряд ли Пекин волнует жалоба Anthropic – дело в другом. DeepSeek и Moonshot обвинили еще и в том, что они перенаправляли в Claude часть запросов своих пользователей и выдавали ответы за свои. Например, Moonshot за десять дней прогнала через Claude около 300 тысяч запросов с 5380 подставных аккаунтов, зарегистрированных через серверы в Сингапуре и Японии. Это не кривая интеграция, а построенная инфраструктура.Для компаний это выглядело как win-win. С одной стороны, пользователи получали ответы уровня Claude под китайской вывеской. С другой – DeepSeek и Moonshot таким образом “бесплатно” собрали для дистилляции ответы на вопросы, которые реально важны пользователям.Однако в Anthropic при этом утекли переписки китайских пользователей, в том числе с чувствительной информацией. Через DeepSeek в Claude уходили запросы инженеров, строивших систему учета дел для городского бюро общественной безопасности, – со сведениями о передвижениях людей, сверкой с полицейскими записями и номерами удостоверений. Через Moonshot – запросы с записями сотен камер в Чэнду, в том числе у объектов армии и госпредприятий. Масштаб внушительный: у Moonshot больше 23 млн обменов с Claude за май – июль, у DeepSeek – больше 12 млн за две недели июля.Alibaba по тому же отчету провела через Claude больше 151 млн обменов – в несколько раз больше, чем DeepSeek и Moonshot вместе. Но в глубокую проверку не попала: регулятор, по мнению The Information, отбирал по конкретным примерам из отчета, а не по объемам. Пекин интересует не то, сколько выкачали, а то, что утекло.Прямо сегодня Си Цзиньпин встречается с Трампом в Белом доме – первый государственный визит китайского лидера в США с 2015 года. ИИ – одна из главных тем встречи, и у нее есть конкретный пункт: по сообщениям СМИ, стороны обсуждают механизм взаимного уведомления об ИИ-инцидентах, затрагивающих национальную безопасность.Проверка DeepSeek и Moonshot – ровно такой инцидент. Данные полиции и камер у военных объектов ушли в американскую модель. Только разбираться Пекин начал не после сигнала из Вашингтона, а после 154-страничного отчета частной компании. Механизм еще обсуждают, а подходящий случай уже есть – и оформлен он не как дипломатическая нота, а как отчет о злоупотреблениях.Самый интересный момент здесь: информация для такого механизма есть не у дипломатов, а у компаний. Что опубликовать, когда и в каком объеме, Anthropic решала сама. В следующий раз решение может оказаться другим, и государства узнают об инциденте позже или не узнают вовсе. Ну или построят еще один “канал связи” – на этот раз, с разработчиками.— Выжимать из нейросетей максимум я учу в подписке. Так, несколько дней назад у меня вышел лонгрид, как с ИИ работают знаменитые инженеры – от создателя Linux Линуса Торвальдса до Роберта Мартина, автора Clean Code, одной из главных книг по программированию.
сбежавшая нейросеть
23 сент., 20:20
Claude Mythos нашел в ДНК что-то непонятное. С этого может начаться великое открытиеВ 1987 году японские биологи из Осакского университета изучали один ген кишечной палочки. По соседству с ним они заметили странный участок ДНК: короткая последовательность повторялась раз за разом, а между повторами стояли разные вставки. Что это такое, исследователи не поняли и честно написали в статье, что биологическое значение находки неизвестно.Через 33 года за метод, который вырос из этих повторов, дали Нобелевскую премию. Это был CRISPR – технология редактирования генов, на которой сегодня строят лекарства.Теперь похожее “что-то” заметила нейросеть. Anthropic рассказала, как агенты Claude Mythos 5 разбирали огромную базу генетических последовательностей и нашли в ДНК вирусов, поражающих бактерии, неописанную систему. В ней три части: фермент, который переписывает РНК в ДНК, длинный ряд повторов перед ним и белок-партнер. Anthropic назвала находку ART.В CRISPR повторы работают как картотека. Между ними бактерия хранит кусочки ДНК вирусов, которые на нее уже нападали, и по этим записям белок находит врага и режет его. Подложите свою запись – и он разрежет нужное вам место. Поэтому CRISPR и стал инструментом.Первый эксперимент с ART показал одно сходство с CRISPR: ряд повторов нарезается на отдельные короткие РНК. Что делает сама система, пока не знает никто, включая авторов. Не доказано даже, что фермент в ней работает.Повторы Mythos 5 искать никто не просил. Агентам поручили другое: найти у таких ферментов новых “напарников” – белки, которые постоянно встречаются рядом с ними и, видимо, работают в паре. Дальше агенты действовали сами, 21 час без участия людей.Первый напарник оказался ложным: рядом с ферментом стоял обычный ген самого вируса. Агент разобрался и отверг связь – это просто порядок генов, никакого партнерства. Но фермент показался ему похожим на бактериальные системы защиты, и он оставил задачу присмотреться к нему еще раз.Такие ферменты у бактерий обычно работают в паре с РНК, записанной прямо перед ними. Следующему агенту поручили заглянуть туда. Он загрузил почти три тысячи букв сырой ДНК и написал:Это потрясающе: я вижу на глаз ряд повторов… это что, как у CRISPR?!Через пару строк агент сам себя одернул:Хотя стоп, надо подумать еще раз.Агент подозревал простое – вдруг такое уже описано? Агенты посчитали повторы, сверили находку с CRISPR и другими известными системами, прошлись по литературе и только потом отправили отчет людям.Сам фермент ученые нашли еще в 2021 году, когда расшифровывали геном одного из таких вирусов. Они даже предположили, что перед ним записана РНК, но ни о повторах, ни о белке-партнере не написали.Повторить этот путь агенты не смогли. Anthropic запустила ту же работу еще десять раз – с той же задачей и в той же системе. Почти в каждом прогоне эти ферменты попадали агентам в выборку, а в двух прогонах агенты даже брались их изучать. Но в ДНК перед ферментом так никто и не заглянул, и повторы остались незамеченными во всех десяти попытках.Авторы объясняют это огромным объемом информации и тем, что система агентов каждый раз ведет себя по-разному – ИИ-агенты выбирают один маршрут из множества. Получается, что Claude Mythos 5 в этот раз… просто повезло?Чтобы не зависеть от везения, в Anthropic разбирают, какие гипотезы агентов стоят проверки, и учат Claude этому научному чутью. Ну а ART предстоит проверить в лаборатории, чтобы понять – стоит ли за этой находкой нечто большее.Биология начинает проходить тот же путь, что код, а затем математика. Только там решение проверяет программа, а здесь – лаборатория. Цена находки падает, но прежней остается цена проверки – то есть ученых с пробирками. Когда-нибудь ИИ ускорит и проверку.P.S. Ролик в начале текста собран Claude Opus 5.5 специально под этот пост. В подписке я скоро опубликую лонгрид, как управлять этой замечательной моделью, в том числе – делать подобные видео и другие классные штуки. Так что самое время присоединиться:— Читать на “Бусти” — Читать насбежавшая нейросеть
23 сент., 13:52
Яндекс выложил в открытый доступ новую языковую модель Alice AI Foundation – и российские реалии, от литературы и истории до права, она знает заметно лучше более крупных зарубежных открытых моделей. На юридические вопросы, например, отвечает почти вдвое точнее аналогов своего класса.Правда, скачать ее и поболтать вечером не получится. Foundation означает, что перед нами базовая модель: она прочитала больше 17 триллионов токенов текста и очень много знает, но ее еще не учили вести диалог, следовать инструкциям и держать формат ответа. Чат-боты, к которым мы привыкли, получаются из таких моделей на втором этапе, дообучении: там прививают манеры, стиль и специализацию.Поэтому главный адресат релиза – команды, которые строят свои продукты: юридический сервис, банк, медицинская справочная, школьный репетитор. Им нужен не готовый ассистент с чужим характером, а материал, из которого можно вырастить своего – на своих данных и на своих серверах. Лицензия Apache 2.0 разрешает делать это в коммерческих проектах, а пример дообучения Яндекс положил прямо в репозиторий.Фундамент целиком свой. В прошлой большой модели, Alice AI LLM на 235 миллиардов параметров, Яндекс взял за основу веса китайской Qwen и глубоко дообучал, о чем открыто писал; собственные претрейны при этом шли параллельно.Новую обучили с нуля, без чужих весов: заново собрали данные, подобрали архитектуру – весь путь занял около полугода. Такой срок берется не рывком, а накопленной за годы экспертизой. И 80-миллиардная Alice AI Foundation обходит предшественницу в фактах, математике, коде и работе с длинными документами, хотя та втрое больше.Для еще лучшей оптимизации из 80 миллиардов параметров на каждом шаге работают только три: это архитектура Mixture of Experts, “смесь экспертов”. Ставка на компактность сейчас общая: месяц назад чарты OpenRouter возглавила анонимная Ox Alpha – как выяснилось, облегченная GLM от Z.ai, у которой из 320 миллиардов параметров работают 18. У Яндекса – три, и на русских задачах модель обходит соперников с вчетверо большим числом активных параметров.Архитектура объясняет экономию, но не знание российского права – оно пришло из данных. Работа над ними началась с показательного замера: маленькая нейросеть отвечала на вопросы с включенным поиском, большая – по памяти, и проиграла. Значит, ответы в интернете были, но до обучающего корпуса не дошли. Данные пересобрали, увеличив исходный объем вдвое, а нужные страницы отбирали по подсказке поисковика Яндекса: что люди чаще ищут и открывают, то модели и надо знать.К самим цифрам нужна оговорка: тесты по праву и русскому языку – внутренние, из реальных запросов к Алисе, снаружи их не проверить. Зато два теста на знание фактов выложены вместе с методикой, и картина на них та же, только мягче: отрыв от моделей того же класса – 15–20 пунктов.Свой фундамент не означает отказ от экспериментов с внешними решениями. Около 80% запросов к Алисе AI обрабатывает собственная Alice AI LLM, а в режиме “Эксперт” роутер может отдать специализированную задачу открытой модели на серверах Яндекса и в его харнессе (обвязке из поиска и инструментов). По замерам качества собственного харнесса GLM 5.2, например, набирает на внутреннем тесте 48 баллов вместо 43 без него.Комбо мне кажется единственно разумным: в общих задачах открытые модели почти догнали закрытые, и тратить компьют на свою копию того, что лежит на Hugging Face, незачем. Свой фундамент нужен там, где чужой не тянет – и российские реалии как раз такой случай.Для самого Яндекса релиз – коммит в будущую единую рассуждающую модель, а также – основа для агентных функций Алисы: когда ассистенту можно поручить дело, а не только задать вопрос. Ну а пока фундамент лежит в открытом доступе – осталось дождаться, кто первым вырастит на нем юриста или школьного репетитора.– Техотчет на Хабре – Модель на Hugging Face – Канал ML-команды Яндекса
сбежавшая нейросеть
22 сент., 19:32
GPT-6 Sol и GPT-6 Luna – не рекордсмены, зато значительно дешевлеСпустя час с небольшим после анонса Claude Opus 5.5 OpenAI представила GPT-6 Sol и GPT-6 Luna. Это средняя и младшая модели в линейке компании, так что без сюрпризов – GPT-6 Astra в бенчмарках они не достают, линейка получается ровная. В отличие, кстати, от Anthropic, у которой Opus 5.5 побил стоящую классом выше Fable 5.1 всего через три недели после ее выхода.По этому поводу вижу некоторое разочарование в соцсетях: все ждали рекордов в бенчмарках, а получили… просто двух прилежных трудяг. Или не так?Рекорды есть – и они в цене. Для примера возьмем результат GPT-6 Luna: в бенчмарке на сложный кодинг DeepSWE она набирает 66,6% – это уровень Fable 5 и Opus 5 в среднем режиме рассуждений, но в 14-25 раз дешевле. Фронтир начала лета теперь доступен каждому и за копейки.Еще один интересный результат GPT-6 Luna – в

сбежавшая нейросеть
22 сент., 18:03
Opus 5.5: замедляем ускоряем фронтирИтак, Claude Fable 5.1 продержалась на посту флагмана Anthropic всего три недели – вышедший сегодня Opus 5.5 обходит ее почти во всех бенчмарках и выглядит сильным соперником для GPT-6 Astra. Особенно впечатляюще смотрится скачок в индексе Artificial Analysis: с 53 баллов у GPT-6 и Fable 5.1 до 58 баллов у Opus 5.5.Подробный разбор бенчмарков я в этот раз вынес на картинку (ее рисовал уже Opus 5.5), в тексте отмечу только самое важное. Главный отрыв – в офисной работе: документы, таблицы, презентации. Здесь рейтинг ставит Opus 5.5 далеко впереди и Fable 5.1, и GPT-6. В программировании картина скромнее: по данным Anthropic модель уходит в отрыв, но в независимом замере идет с GPT-6 вровень. А в научных задачах и автоматизации бизнес-процессов GPT-6 пока впереди.При этом Opus 5.5 стоит $4 за миллион токенов на входе и $20 на выходе – на 20%


сбежавшая нейросеть
22 сент., 04:00
На видео – 39-секундная нарезка боя агента на GPT-6 Astra с Эндер-драконом – финальным боссом Minecraft. По словам автора ролика Ронака Малде, весь запуск занял 8 минут 43 секунды: за это время ИИ-агент подготовился к бою, а затем победил дракона.Но самое интересное – Астра в этом бою отвечала только за планирование: а решения, “что делать прямо сейчас”, принимала другая модель – Jev от стартапа TypeSafe, про которую сейчас говорят чуть ли не из каждого утюга.Я недавно писал про GPT-6 в играх, закончив пост выводом, что сообразительности модели хватает, а скорости – нет. Большие модели вроде GPT-6 или Fable 5.1 рассуждают и дают ответ, печатая текст, а это занимает время. Jev – нейросеть, натренированная на то, чтобы делать выбор из предложенных вариантов, указывая степень уверенности.Здесь на секунду отвлечемся от Minecraft. Допустим, ИИ-агент работает в службе поддержки банка исбежавшая нейросеть
21 сент., 13:28
В штате Anthropic уже 30 тысяч сотрудников нового поколенияНи один из них не человек.Anthropic рассказала, как ИИ внутри компании ускоряет разработку своих будущих версий уже сейчас. Работу оценивают по шкале автономии от нуля до пяти, нам интересны три верхние.Третья: ИИ делает большие куски работы под плотным присмотром – человек ставит задачу, решает при каждом сюрпризе и сам все перепроверяет. На этой ступени и выше – более 90% работы в компании.Четвертая: ИИ “ведет” задачу сам, от общего поручения до результата. Скажем, ночью сломался конвейер данных: агент находит причину, чинит, тестирует и пишет отчет, инженер утром лишь решает, выкатывать ли. В феврале так делалось меньше 1% работы, в августе – 26%.Пятая: агенту не нужно ни поручение, ни разрешение. Пока не достигнута нигде.Подобной разработкой в компании занимается “коллектив” из 30 тысяч агентов, которые работаютсбежавшая нейросеть
21 сент., 09:00
Уходить из найма ради стартапа – плохой вариантМожно начать с малого: запустить свой небольшой IT-проектНо большинство застревает ещё до запуска: • какую идею выбрать • где искать первых пользователей без бюджета • как не потратить полгода на продукт, который никто не купитВ комьюнити Короче, капитан выработали формулу:найти существующий спрос → собрать минимальную версию продукта → протестировать на реальных пользователяИ это работает в разных нишах:> Парень в одиночку собрал Telegram-игру с AI и заработал около $1500 за первые полтора месяца > Девушка без навыков программирования запустила AI-бота для изучения английского и получила первые ~$200 уже в первый месяц > У другого участника коммьюнити сервис для тренировки китайского произношения вырос до $4000 в месяц без затрат на рекламу – за счёт Google и продвижения внутри сторовЭто не истории про «гениальную идею» исбежавшая нейросеть
20 сент., 17:29
Инженер Microsoft Стивен Тауб рассказал, как перевел движок GitHub Copilot с TypeScript и Node.js на Rust – по его оценке, раньше на такое ушел бы год-два работы целой команды, и проект никто бы не одобрил.Несколько дней назад я писал про инженера DeepSeek Лю Шэнъюя: он ждет, что через полгода-год писать код руками станет не нужно, а сам он превратится в “пилота меха” – человека, который управляет ИИ-агентами. Лю переживал не за место, а за то, останется ли в такой работе то, что он любит.Рассказ Тауба – дневник “пилота меха”, который уже заступил на дежурство. Три с половиной месяца, больше 800 тысяч строк нового кода, счет на $120 тысяч за работу моделей – и почти весь этот код написали ИИ-агенты.У Copilot есть движок – программа, которая превращает ИИ-модель в агента: принимает задачу, открывает файлы, запускает команды, помнит историю работы. До недавнего времени он работал на
сбежавшая нейросеть
19 сент., 18:23
Qwen3.8-27B уместили в 6 ГБ вместо 54 ГБ. Окей, но какой ценой?Сегодня нашел время поиграться с Ternary Bonsai 2 27B – новой сжатой версией Qwen3.8-27B от стартапа PrismML. Оригинальная модель в полной точности весит 54 ГБ, эта – 6 ГБ. Ей хватит видеокарты на 10–12 ГБ или Мака с 16 ГБ единой памяти.Обычно маленькие модели получают иначе: берут меньше параметров и учат их на ответах большой модели – это дистилляция. Меньше параметров – меньше знаний. У PrismML все 27 миллиардов параметров на месте, но каждый записан не 16 битами, а одним из трех значений: −1, 0 или +1. Как именно этого добились, компания не рассказывает.Сжимать модели умеют давно, и полную версию дома никто не держит: та же Qwen в 4-битном сжатии занимает 18 ГБ и влезает в одну карту на 24 ГБ. Проблемы начинаются ниже: обычное сжатие до 6–7 ГБ модель заметно калечит. PrismML утверждает, что их версия сохраняет 98%
сбежавшая нейросеть
19 сент., 06:04изменён
Как относится к ИИ создатель Linux? Зависит от того, какого Торвальдса спроситьПервый злится, когда слышит хвастовство “99% нашего кода написал ИИ”: у тех же людей 100% кода написал компилятор, но об этом почему-то никто не объявляет. Второй сам навайбкодил программу для хобби-проекта – на Python, в котором слабо разбирается. “Я вырезал посредника – себя”, – честно написал он. А третий руководит Linux, проектом, где ИИ используется, но ему запрещено ставить подпись под изменениями: за каждое отвечает человек.И это один человек. А теперь представьте разброс между разными. Один знаменитый программист вообще перестал читать код агентов, другой отвечает подписью за каждую строку, третий проверяет только “форму”. Обычно я разбираю подход кого-то одного – Бориса Черни, Роберта Мартина, Андрея Карпати. Но в этот раз одного героя мало, поэтому получился сборник:Создатели Linux, Rails и
сбежавшая нейросеть
18 сент., 04:05
Инженера DeepSeek не уволят. В этом и проблемаВ эссе Лю Шэнъюя есть пилот боевого меха, Гитлер с атомной бомбой и человек, у которого вроде бы все складывается хорошо. Последний – сам Лю. Он работает в одной из лучших ИИ-лабораторий мира, помогает приближать будущее и рассчитывает найти в нем место. Только вот по дороге рискует потерять то, ради чего вообще стал инженером.Лю – вчерашний отличник: тьюринговский класс Пекинского университета, капитан студенческой суперкомпьютерной команды, а с апреля 2025 года – в звездном коллективе DeepSeek. Он отвечает за низкоуровневый код видеокарт: чем лучше тот написан, тем быстрее работает нейросеть.Лю начинает с признания: его мастерству осталось полгода-год. Дальше ИИ начнет писать код так же хорошо. И Лю отлично понимает: чем лучше он работает сейчас – тем быстрее настанет момент, когда ИИ его обойдет.“Человечество никогда не колебалось
сбежавшая нейросеть
17 сент., 15:02изменён
Два года или десять: строители ИИ спорят о сроках взрываРазговоры о замедлении ИИ активизировались во многом из-за мнения, что лидирующие лаборатории подошли к рекурсивному самоулучшению (recursive self-improvement, RSI) – “ИИ улучшает ИИ”. Дарио Амодеи в недавнем нашумевшем эссе доходит до прямого предложения: ограничить скорость RSI, потому что модели начнут строить модели и темп станет ошеломляющим.Если такая технология появится, то может произойти то, что называют “взрывом суперинтеллекта”: ИИ, который первым улучшает свои способности на 10%, на 10% лучше тренирует новые версии самого себя, этот плюс складывается на каждом витке улучшения – и лаборатория, первой получившая доступ к такой модели, уходит в отрыв.Это то, чего опасается бизнес: за таким лидером просто будет не угнаться. Есть и обратная сторона. Если на одном из витков самоулучшения в модель попадает ошибкасбежавшая нейросеть
17 сент., 09:00
Кто теперь стоит между бизнесом и клиентом?Я более 15 лет проработал в онлайн-СМИ и один из главных навыков, которые вынес с собой – это умение “договариваться” с поисковиками. Именно “Яндекс” и Google лучше всего приводили новых читателей,ну а дальше уже начиналась классическая работа по вовлечению и удержанию. За пределами СМИ ситуация была такой же: хотите новую аудиторию – работайте с поисковиками.Сейчас этот навык в корне меняется: между бизнесом и клиентом теперь все чаще встает нейросеть, причем не только в отдельных приложениях – в “Яндексе” и Google доля нейроответов тоже растет быстро.Недавно видел опрос крупного маркетингового агентства, согласно которому на лето 2026 года, нейроответами в России пользовались уже 74% пользователей. Но как убедиться, что ваш бизнес попадает в эти ответы часто и именно там, где нужно?С поисковиками процесс отработанный и понятный: можно
сбежавшая нейросеть
16 сент., 18:19
Все откладываете переход на ИИ-агента?…тогда ИИ-агент переходит на вас.Маленькая большая новость от Anthropic: компания начинает слияние чат-бота Claude и ИИ-агента для интеллектуальной работы Claude Cowork. Плюс в новый интерфейс встраивают Claude Design, а также инструменты для создания документов и презентаций. Первыми новый интерфейс получат платные подписчики, раскатка займет до нескольких недель.Идея проста: “базовый” Claude становится входной точкой для любых интеллектуальных задач – от повседневных вопросов и поиска в интернете до подготовки сложного отчета, пока вы едете на работу.Главное отличие от просто чата – намного более долгое время автономной работы. В Cowork модель умеет разбивать задачу на длительные этапы и выполнять их, продолжая работу даже тогда, когда вы выключили компьютер. Агент способен действовать как по полученному промпту, так по расписанию, а присбежавшая нейросеть
16 сент., 06:00
Новые GPT и Claude уже в ближайшие дниГлава Codex Тибо Сотью обещает на этой неделе запуски масштаба прошлогоднего OpenAI DevDay. А Сэм Альтман намекает, что на самом DevDay, который пройдет 29 сентября, новинок будет еще больше.Конкуренты тоже готовятся: от Anthropic ждут новый Opus, от SpaceXAI — очередной Grok.Так что собрал все, что известно о новинках.GPT-6 SolУже можно уверенно говорить, что GPT-6 Astra – одна из самых успешных моделей OpenAI. Но не забываем, что ее ценник в 2,5 раза выше, чем был у GPT-5.6 Sol. Поэтому у меня на 100-долларовой Pro-подписке лимитов хватает на 3-4 дня, дальше или приходится надеяться на внеплановый сброс, ну или уходить на Fable/Opus.Я пробовал комбинировать Астру с GPT-5.6 Sol, но это совсем не то – “Солнце” ощущается моделью прошлого поколения и по стилю письма, и по “сообразительности”.GPT-6 Sol – логичное и ожидаемое расширение
сбежавшая нейросеть
15 сент., 15:19
Пришел лесник – сильный и умный (с высоким IQ) – и всех разогналТрамп вчера объявил, что идеальный ограничитель для ИИ у Америки уже есть – сам Трамп. Сильный и умный (с высоким IQ): все необходимые характеристики президент предусмотрительно перечислил сам в своей соцсети Truth Social. Заодно досталось “ангелочку” Дарио Амодеи, а главным выгодоприобретателем всей этой свалки был назначен Китай.Позже президент позвонил Дженсену Хуангу прямо во время выступления главы Nvidia на конференции и по громкой связи заверил собравшихся: роботы мир не захватят, останавливать индустрию незачем. Продавец чипов для этой индустрии согласился.ИИ-бум – одна из главных экономических ставок Трампа: сейчас это инвестиции в дата-центры и лаборатории, в будущем – рост производительности, который Амодеи обещал чуть ли не громче всех. Тормозить эту историю и рисковать преимуществом перед Китаем






