
Последние посты

fmin.xyz
4 июл. 2025 г., 10:56
🧬 Эволюционные алгоритмыПолтора месяца назад DeepMind выкатил AlphaEvolve, где LLM-агент генерирует, скрещивает и отбирает фрагменты кода на основе эволюционного подхода. Так появляются новые алгоритмы — от рекордов в матричном умножении до оптимальных расписаний вычислений и топологий печатных плат для TPU. Сообщество уже откликнулось опен-сорсным OpenEvolve — можно запустить тот же процесс самому и выращивать свои программы.На анимации — пример: генетический алгоритм оптимизирует расписание светофоров. Есть улица с несколькими светофорами. Каждый дважды зажигает красный на фиксированное время, чтобы пропустить пешеходов. Если времена выбрать случайно (верхний ролик), поток машин разваливается, пропускная способность падает. Эволюция чинит это: алгоритм ищет расписание, которое пропускает больше автомобилей.Расписание описываем вектором моментов, когда включается красный:1-й 🚦fmin.xyz
28 февр. 2025 г., 13:57
QR алгоритм🥸 Одна из жемчужин численных методов. Он используется для поиска собственных чисел матрицы.🥰 Простой и стабильный, а при небольших модификациях ещё и быстрый.Qₖ, Rₖ = qr(Aₖ) - Вычисляем QR-разложение матрицы Aₖ₊₁ = RₖQₖ - Умножаем факторы в обратном порядке😑 Для произвольной квадратной матрицы он сходится к верхнетреугольной матрице, на диагонали которой стоят её собственные числа (картинка слева)👍 Если же матрица - симметричная, то он сходится вообще к диагональной матрице собственных чисел (картинка справа).Идея анимации взята у Gabriel Peyré - один из лучших аккаунтов по красивым математическим визуализациям. По моим предварительным исследованиям, после этого поста отпишется наибольшее количество уважаемых подписчиков.fmin.xyz
12 февр. 2025 г., 11:38
Наглядно о том, зачем нужна нормализация признаковПростая анимация, которая показывает фиксированное число итераций градиентного спуска, стартующего из одной и той же точки для хороших и плохих задач.В хороших задачах направления примерно одинаковы с точки зрения значений минимизируемой функции. Для квадратичной функции (aka линейная регрессия) это измеряется числом обусловленности гессиана.Явление характерно не только для квадратичных функций - это одна из главных причин наличия разных нормализаций в нейросетях.👨💻 Код для построения анимацииfmin.xyz
31 янв. 2025 г., 14:59
Подбор шага с помощью линейного поиска в градиентном спускеЕсли нам известны характеристики сильно выпуклой функции, то мы можем выбрать оптимальный постоянный шаг 2/(μ + L), где μ и L – наименьшее и наибольшее собственные значения гессиана функции.Однако на практике эти параметры почти никогда не известны. Да и функции бывают невыпуклые. Приходится подбирать learning rate вручную (перебор), линейным поиком или использовать эвристики/адаптивные алгоритмы (например, AdamW, NAG-GS).В первой части видео мы минимизируем функцию Розенброка с помощью градиентного спуска с разными постоянными шагами, отличающимися всего в 2 раза. Разница в поведении методов – колоссальная!Во второй части видео демонстрируются работа методов линейного поиска для решения этой задачи: 📝 Метод золотого сечения - прекрасный вариант для выпуклых функций, но если функция неfmin.xyz
5 дек. 2024 г., 14:02изменён
О чем пишут на ICLR 2025Пока все ждут результаты ревью одной из самых главных конференций по AI, вот анализ ключевых слов работ, поданных на неё.Всего в датасете около 9600 работ (подано вроде чуть больше), а самые популярные категории (фул картинки и полный датасет в комментариях):1797: large language models 592: diffusion models 458: reinforcement learning 291: transformers 280: graph neural networks 247: generative models 222: deep learning 210: benchmark 210: representation learning 194: interpretability 175: ai safety 160: alignment 160: multimodal large language models 135: in-context learning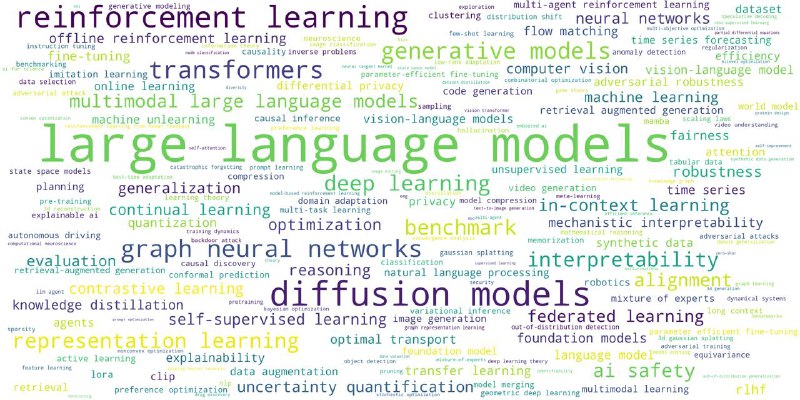

fmin.xyz
30 нояб. 2024 г., 17:59изменён
Как ускоряли обучение GPT-2 S в 10 раз🤩Очень интересный репозиторий Modded-NanoGPT, и набор тредов о том, как спидранили обучение GPT-2 (самой маленькой версии на 125М параметров).😎 Результат был достигнут на 8xH100 за 4.7 минуты на PyTorch вместо 45 минут в бейзлайне (llm.c). В денежном выражении это экономия с ~$15 до ~$1.56.Представляете, обучение GPT-2 S с нуля теперь стоит $1.5 и занимает 5 минут. А обучение XL модели ~$200 и 10 часов.😂 Стоит обратить внимание, что всё это произошло за счёт алгоритмических/модельных улучшений. Потенциально можно все эти трюки перенести обратно с Python на C чтобы получить ещё более быстрое обучение, ведь эффективность обучения на один токен у llm.c всё равно выше (где-то на 25% для GPT- 2 XL).🐱 Самые больш
fmin.xyz
31 окт. 2024 г., 10:00изменён
В начале октября вышел ежегодный отчет State of AI Report 2024🔗СсылкаПомимо обзора прогресса за последний год, в конце есть секция с предсказаниями (в прошлом репорте 5 из 10 предсказаний сбылась, 3 не сбылись). Поставлю интуитивные имхо 🟢/🔴, если согласен/не согласен - проверим через год.1️⃣ Вложение более 10 млрд $ от государства в крупную американскую AI лабораторию вызовет проверку на уровне национальной безопасности. 🔴 Такое вообще бывало? Чтобы в критически важную технологию вкладывали так много другие государства?2️⃣ Приложение или сайт, созданные без навыков программирования, станут вирусными и попадут в Топ-100 App Store. 🟢 Было и в докурсорную эпоху.3️⃣ Крупные AI лаборатории внесут значимые изменения в процесс сбора данных после первых судебных разбирательств. 🔴 Нет.4️⃣ Раннее внедрение AI акта ЕС окажется мягче, чем ожидалось, после опасений по поводу
fmin.xyz
13 окт. 2024 г., 11:58изменён
Нейронная сеть Хопфилда🏆 На этой неделе нобелевскую премию по физике дали Джону Хопфилду и Джеффри Хинтону за основополагающие открытия и изобретения, которые позволяют использовать машинное обучение с помощью искусственных нейронных сетей.😲 Я, как и многие в моем окружении, сначала недоумевал, почему так и причем здесь физика. И решил заботать, что вообще такое нейронная сеть Хопфилда, и получил дикое удовольствие. Оказывается, что сама концепция заметно отличается от тех нейронных сетей, к которым мы привыкли. В этих сетях гораздо больше связи с физикой и биологией, чем в полносвязных/сверточных слоях.🔬 Что это такоеВ простейшем случае это однослойная нейросеть, в которой все нейроны соединены со всеми и каждый нейрон может принимать два значения (-1 и 1 - как знак заряда илиfmin.xyz
9 сент. 2024 г., 11:46
Почему все используют градиентные методы для обучения больших моделей?🤩 Продемонстрирую наглядно на примере решения задачи Multidimensional Scaling (MDS). В этой задаче нам надо нарисовать на плоскости объекты, про которые мы знаем только насколько каждый из них далеко друг от друга. Т.е. на входе у нас матрица попарных расстояний, а на выходе координаты объектов на плоскости. Причем эти координаты должны быть такими, чтобы соотношения расстояний между объектами оставалось как можно более близким к исходным. В качестве функции потерь выступает сумма квадратов отклонений расстояний между городами при текущих координатах и заданным значением.f(X) = ∑ₘ ∑ₙ (Dₘₙ − dₘₙ(X))²🗣 Несмотря на увеличение размерности, вся траектория метода может быть наглядно продемонстрирована на плоскости. Количество переменных в задаче здесьfmin.xyz
20 июл. 2024 г., 13:46
Мам, я хочу double descent - у нас есть double descent дома!💀 Феномен двойного спуска - явление, наблюдаемое в моделях машинного обучения, при котором при увеличении сложности модели на тестовых данных сначала наблюдается улучшение качества предсказаний (первый спуск), затем идёт ожидаемый рост ошибки (переобучение), а потом, внезапно, происходит улучшение обобщающей способности модели (второй спуск). Интересно, что похожую картинку можно получить на довольно простом примере полиномиальной регрессии. На анимации выше слева 50 точек синусоиды, которые используются в качестве train set для обучения полиномиальной регрессии.😎 Типичное поведение при увеличении степени полинома - переобучение, т.е. почти нулевая ошибка на трейне (синих точках слева) и высокая ошибка на тесте (равномерно расположенные 100 точек на чернойfmin.xyz
16 июл. 2024 г., 18:49
Сегодня я планировал быть в Барселоне, рассказывать нашу работу по квантизации LLM на конференции UAI, но т.к. мой шенген делают уже больше месяца, я был вынужден использовать последнюю диффузионную модель Stable Paint, чтобы добавить меня к постеру, который, к моей большой радости, всё же был представлен @Ivan_Oseledets.Когда приведу в порядок код, напишу пост про сам алгоритм (он прикольный - матрица раскладывается на 2 слагаемых, каждое из которых хорошо квантизуется), а пока оставлю постер в комментах.
fmin.xyz
10 апр. 2024 г., 18:50
Почему стохастический градиентный спуск не сходится?👍 Многие привыкли использовать SGD(stochastic gradient descent), но не все знают, что он гарантированно(!) не сходится в случае постоянного шага (learning rate) даже для самой приятной в мире функции - сильно выпуклой квадратичной (даже в среднем).😰🧠 Почему так? Дело в том, что в SGD на каждой итерации на самом деле решается другая задача, построенная по выбранным данным. И эта задача на батче может радикально отличаться от полной задачи (однако, внимательный читатель может отметить, что это не гарантирует очень плохой шаг😬). То есть на каждой итерации мы на самом деле сходимся, но к минимуму другой задачи, и каждую итерацию мы меняем правила игры для метода, не давая ему ему пройти больше одногоfmin.xyz
20 мар. 2024 г., 15:19
Коварный метод Ньютона🏌️ Безнапряжная эстетика направлений движения методов оптимизации для невыпуклых задач.🚶♂️Метод Ньютона легко сходится не только к минимумам (светлые области), но и к максимумам (темные области). Дело в том, что метод строит квадратичную локальную аппроксимацию функции и если вдруг она не выпукла, то он может построить параболу ветвями вниз и уверенно проследует в её максимум.То есть вы вроде применили метод оптимизации для минимизации функции, а она возьми и увеличься 😊. Для градиентного спуска с правильным шагом такого быть не может, антиградиент всегда смотрит в сторону локального убывания функции.🎯 Здесь в анимации все направления стрелок отнормированы, т.е. показывают лишь направление движения метода, запущенного из точки.fmin.xyz
10 мар. 2024 г., 11:11
Непредсказуемая сложность MIP💡 Есть такая особенность в задачах целочисленного линейного программирования (Mixed Integer Programming - MIP), что по её виду не совсем понятно насколько сложной она будет.🤔 Бывает так, что задача с миллионами переменных и ограничений решается на десктопе быстрее, чем за час, а бывают задачи с тысячами переменных/ограничений, которые до сих пор вообще никак не решены любыми средствами и солверами (в т.ч. коммерческим Gurobi).😢 Однако, если позволить переменным быть не только целочисленными, но лежать в некотором отрезке (выпуклая релаксация MIP), то почти всегда такая задача сильно проще решается (есть полиномиальные алгоритмы для LP, в отличие от MIP), но нет никаких гарантий, что полученное решение будет целочисленным.📦 Датасет.
fmin.xyz
22 февр. 2024 г., 13:04
l₁ регуляризация стимулирует разреженность решения🤨 При обучении линейной регрессии иногда хочется найти не просто вектор весов, с которыми надо учитывать фичи, но и стимулировать этот вектор обладать некоторыми свойствами.📝Фишки l₂ - регуляризации (Ridge-регрессия): Единственность решения, чего нельзя гарантировать в исходной задаче. Новая задача становится лучше обусловлена. Задача гарантированно становится сильно выпуклой.📝Основная фишка l₁ - регуляризации (Lasso-регрессия) - это разреженность решения или автоматический выбор признаков. В векторе оптимального решения будет заметное количество нулей, что позволяет снизить количество используемых признаков.🤔 На гифке показано решение эквивалентных задач оптимизации (сверху Ridge, снизу Lasso) -fmin.xyz
21 янв. 2024 г., 19:15
Визуализация сжатия матрицы с помощью усечённого SVD🤓 Теорема Эккарта - Янга - Мирского говорит, что для любой матрицы A её лучшим приближением заданного наперёд ранга r является усечённое сингулярное разложение ранга r. То есть такая аппроксимация Aᵣ , которая получена путём суммирования r матриц ранга 1.Aᵣ = ∑ σᵢ uᵢ vᵢᵀздесь σᵢ - сингулярные числа (важно, чтобы они были отсортированы по убыванию), а uᵢ vᵢ - левые и правые сингулярные вектора. Для анимации выше можно один раз посчитать SVD (A = U Σ Vᵀ) и после этого дергать соответствующие значения.🗜️Почему это сжатие? Потому что для того, чтобы нарисовать картинку выше для каждого ранга r нужно r строчек и r столбцов матрицы + r сингулярных чисел. То есть если раньше было, допустим 1920×1080 пикселей, то вместо 2 073 600 значений для ранга 50 надо хранить 150fmin.xyz
29 дек. 2023 г., 10:08
🧠 Самая наглядная демонстрация того, что AB ≠ BAС того самого момента, как в конце школы я узнал, что матричное умножение не коммутативно, меня одолевало возмущение.- Да как так-то? 😡😭 Десятки игрушеных матриц 2х2, перемноженных вручную не оставляли сомнений в этом факте, но понимания не прибавлялось.🤓 Потом выяснилось, что поворот плоскости может быть задан матрицей 2х2. И, конечно же, если вы посмотрите на любую плоскость, вам будет сразу очевидно, что если вы сначала все повернёте на 35°, а потом на 55°, то результат таких поворотов не зависит от порядка поворотов и всегда будет равен одному повороту на 90°. А значит, произведение матриц поворота плоскости не зависит от порядка произведения и AB = BA.🏥 Однакfmin.xyz
25 окт. 2023 г., 15:28
🧠 А вот обычная анимация, иллюстрирующая идею PCA. Здесь видно, что при проекции на ось, соответствующую сингулярному вектору матрицы данных дисперсия проекций наибольшая (можно проверить, покрутив эту ось здесь).fmin.xyz
25 окт. 2023 г., 15:28
Простой пример, когда оптимальное снижение размерности не оптимально для вас.🤔 Пусть перед нами стоит задача классификации данных с 2 классами (крестики и кружочки). Но при этом нам нужно снизить размерность этих данных. Вот, например, здесь размерность каждой точки на плоскости 2, а нам нужнно 1.👍 PCA (метод главных компонент) позволяет найти такие оси, проекция данных на которые оставляет наибольшую дисперсию этих проекций. Интуитивно кажется, что такой выбор будет оптимальным с точки зрения сохранения информации о ваших данных при снижении размерности.😭 Однако, при проекции на оптимальную ось, задаваемую первым сингулярным вектором матрицы данных, мы не сможем различить данные этих двух классов каким-нибудь простым правилом.😎 А вот проекцияfmin.xyz
16 сент. 2023 г., 10:21
Сжатие котиков с помощью PCA😊 Эти котики просто хотели мурчать, залезать в коробки и сталкивать всё со стола. Но сингулярность не могла обойти стороной и их тоже. Им пришлось быть пожатыми с помощью сингулярного разложения 😫.🥹 Четыре случайно выбранных жертвы котика демонстрируют, как можно сжимать изображения с помощью truncated SVD. Если векторизовать весь датасет, то получится матрица A размером 29843 (кол-во котиков) х 4096 (картинки 64х64 преобразуем в ч\б и вытягиваем в вектор).😬 У этой матрицы (как и у любой другой) можно посчитать SVD и найти сингулярные векторы. Зная их и сингулярные числа - легко спроецировать котиков в пространство меньшей размерности, а так же восстановить матрицу исходного размера, но меньшего ранга, оставив





