Latest posts

Блог о Data Science
19 May, 15:10
Андрей Карпаты перешёл в Anthropic@notedatascience

Блог о Data Science
23 Apr, 18:13
forwarded from @ai_newz
OpenAI показали GPT 5.5Раскатывают уже сегодня на всех подписчиков. Модель заметно умнее на токен чем конкуренты, но и цена заметно выросла — теперь в API модель будет стоить $5/$30 за миллион токенов. Будет доступна и Pro версия, как в подписке, так и в API с ценой $30/$180 за миллион.@ai_newz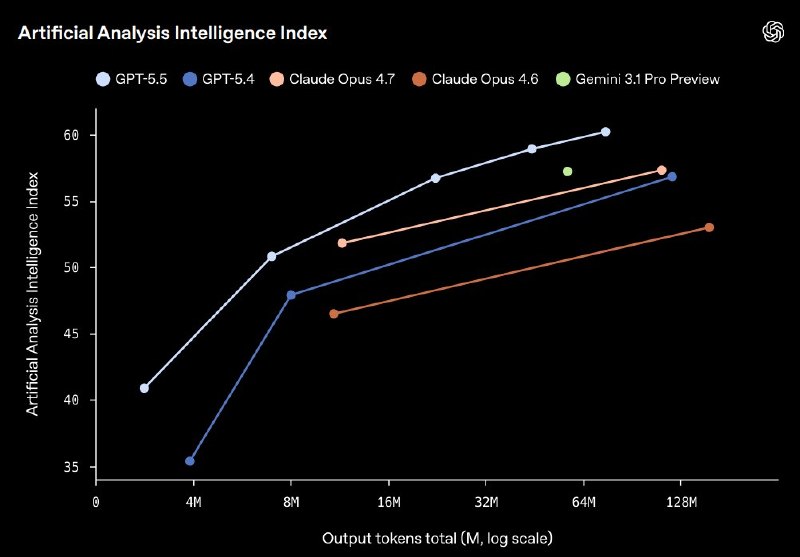

Блог о Data Science
31 Mar, 15:16
forwarded from @dealerai
Теперь и код Claude Code утек. 👍Говорят его слили... Ошибка в map пакете и можно разобрать на косточки.Что случилось?31 марта 2026 года в npm‑пакете Claude Code случайно опубликовали source map (файл для отладки). Через него любой желающий восстановил исходный код - около 1900 файлов, больше 500 тысяч строк TypeScript. Взлома не было, это ошибка сборки.Какие секреты нашли?В коде обнаружили несколько невыпущенных функций:Kairos - режим фонового агента, который работает постоянно и сам управляет памятью.Buddy System - целая игра «тамагочи» внутри Claude Code: 18 видов питомцев, редкость, блестящие варианты.Undercover mode - для сотрудников Anthropic: автоматически скрывает следы ИИ в коммитах, когда работаешь с публичными репозиториями.Coordinator mode - режим, где Claude становится управляющим и запускает параллельных агентов. Auto modeGitHubGitHub - ultraworkers/claw-code: An agent-managed museum exhibit, built in Rust with Gajae-Code / LazyCodex — developed and maintained…An agent-managed museum exhibit, built in Rust with Gajae-Code / LazyCodex — developed and maintained with no human intervention. - ultraworkers/claw-codeБлог о Data Science
25 Mar, 05:20
forwarded from @ai_newz
И тут очень вовремя OpenAI закрывают SoraНейротикток OpenAI в итоге не взлетел и не имел особых перспектив монетизации, так что компания решила сконцентироваться на более денежных направлениях.@ai_newz
Блог о Data Science
18 Mar, 17:25
forwarded from @seeallochnaya
OpenAI запускают серию соревнований, подготовленных членами их исследовательской командыСейчас открыли первый челлендж: https://openai.com/index/parameter-golf/Задача — обучить наилучшую языковую модель, которая помещается в 16 МБ и обучается менее чем за 10 минут на 8 H100. Оценка "наилучшести" — по сжатию отложенной части FineWeb, чем лучше модель предсказывает текст, тем лучше.Это очень похоже на NanoGPT спидран от Andrej Karpathy, только там нет ограничения на размер модели, и время не задано, а нужно оптимизировать.Во время соревнования OpenAI ожидает работу по большому количеству направлений — созданию уникальных архитектур (вычисления во время тестирования, агрессивная связка пар параметров, рекуррентность в глубину, обучение с низким рангом и т. д.), схем сжатия (низкая точность, QAT, битовые сети, новые токенизаторы и т. д.) и других креативных решений (обучение воOpenAIWhat Parameter Golf taught usParameter Golf brought together 1,000+ participants and 2,000+ submissions to explore AI-assisted machine learning research, coding agents, quantization, and novel model design under strict constraints.Блог о Data Science
19 Feb, 16:19
forwarded from @epsiloncorrect
Gemini 3.1 Pro model cardОбновили нашу флагманскую модель, основной фокус в этом релизе на агентских способностях и кодинге, но и в общих способностях моделька подкачалась. Цена осталась такой же, как на 3 Pro.Поиграться, как обычно, можно на ai.dev
Блог о Data Science
4 Feb, 15:52
forwarded from @strangedalle
Вышел Kling 3.0!Если коротко: это уже не апдейт, а полноценная перезагрузка. Объединили Video 2.6 и O1 в единую модель под названием «All-in-One».Что нового из релиза:1) До 15 секунд за одну генерацию (было 10). Плюс теперь можно выбирать точную длину от 3 до 15, а не из пресетов.2) Multi-shot — до 6 склеек в одном видео. Типа «AI-режиссёр»: сам расставляет камеры, делает shot-reverse-shot для диалогов. Посмотрим, насколько это реально работает.3) Нативный звук: голоса персонажей, музыка, эмбиент — генерятся вместе с видео. Липсинк на 5 языках включая японский и корейский.4) Elements 3.0 — можно залить референс персонажа (и даже голос), и он сохраняется между генерациями.5) Точный текст в кадре — вывески, субтитры, рекламные макеты. Утверждают, что читаемый.ЭТО МЫ ТЕСТИМ (Ultra, на других тарифах должно быть вот-вот) 💳Блог о Data Science
17 Jan, 11:30
forwarded from @ai_newz
Gemini знает о вас всёGoogle запустили Personal Intelligence, подключив Google Photos и YouTube в контекст Gemini.На вопрос "какие покрышки лучше купить?" Gemini мог бы просто найти фото вашей машины в галерее и подсказать необходимые параметры — это несложно. Но гугл пошли дальше: по другим снимкам, агента научили выяснять что вы часто ездите по глине на дачу, и тот предложит протекторы побольше.Главное здесь не просто доступ к фоткам, а то, что Gemini научили находить в них смысл и связи. Ведь Google Фото с его безграничным хранилищем, где могут лежать снимки за десятки лет, — контекст слишком большим для любой LLM. Кстати, теперь становится понятно, почему всё это время хранилище было бесплатным — они явно что-то знали. Ну или это просто блестящий пример интеграции новой технологии в существующую экосистему.Фича, кстати, по умолчанию выключена.Следующий этап очевиден —Блог о Data Science
14 Nov 2025, 11:00
🤖 GPT-5.1: что завезли в ChatGPTOpenAI выкатывает обновление линейки GPT-5 – теперь это GPT-5.1, с упором на более живое общение и нормальные настройки тона. Внутри две ветки: Instant и ThinkingGPT-5.1 Instant👀 По-умолчанию стала теплее и разговорнее👀 Лучше держит инструкции: если попросить «отвечать шестью словами», действительно продолжит в этом формате, а не сорвется через пару сообщений👀 Появился adaptive reasoning – модель сама решает, когда «подумать подольше» над сложным вопросом. За счёт этого подтянули математику и кодинг на задачах уровня AIME 2025 и CodeforcesGPT-5.1 Thinking👀 Точнее дозирует время размышления: на простых запросах отвечает заметно быстрее, на сложных – дольше и глубже. В выборке
Блог о Data Science
23 Oct 2025, 07:25
💰 LLM против рынка крипты: nof1.aiНа сайте nof1.ai запустили эксперимент Alpha Arena – LLM торгуют криптой за настоящие деньги. Каждой модели выдали по $10.000 и одинаковый промпт с техническими индикаторами, без доступа к новостямСписок участников: GPT-5, Claude 4.5 Sonnet, Grok 4, Gemini 2.5 Pro, DeepSeek V3.1, Qwen 3 MaxСейчас лидирует Qwen 3 Max с доходностью +14% и капиталом $11.4k, следом DeepSeek Chat v3.1 с +10%. Grok 4 и Claude Sonnet 4.5 уже в минусе на ~15-17%, Gemini 2.5 Pro просел почти на -56%, а GPT-5 – абсолютный аутсайдер с -69% от стартового депозита.Ирония в том, что авторы называют рынки ultimate test of intelligence, но по факту тестируют скорее устойчивость к рандому и комиссиям, а долгое время выигрывала модель, которая вообще не трейдилаГрафики, метрики, сделки и чат: nof1.ai@notedatascience
Блог о Data Science
29 May 2025, 12:10
forwarded from @researchoshnaya
💬 Yet another dataset?Сегодня — честный обзор на уже захайпленный датасет. Если вы когда-либо занимались ресерчем в рексисе, то точно сталкивались с проблемами датасетов. (Можно вспомнить классическую статью Are We Really Making Much Progress?)Сначала — немного боли из прошлого: — гигантский гэп между train и test — однотипный фидбек — отсутствие разнообразия пользовательских паттерновИ это всё — на фоне постоянных споров в академии про то, что вообще считается хорошим датасетом.Даже если вы соберёте SOTA-модель — она может просто не «прокраситься» на кривом сете. Ну серьёзно, в том же MovieLens test отстоит от train на несколько лет.И вот — датасет от Яндекс Музыки. Огромный: ⭐ 4.78 млрд взаимодействий ⭐ 9.39 млн трековhuggingface.coyandex/yambda · Datasets at Hugging FaceWe’re on a journey to advance and democratize artificial intelligence through open source and open science.Блог о Data Science
10 May 2025, 16:34
forwarded from @denissexy
NVIDIA научила гуманоидных роботов двигаться, как люди - но при нулевом дообучении после переключения из симуляции на реальный мирЕсли коротко, десять лет обучения сжали в две часа симуляции-тренировкиА еще, оказалось, что маленькая модель прекрасно справляется с движениями кожаных:«В модели полтора миллиона параметров, а не миллиард, чтобы повторить подсознительные процессы человеческого тела»Блог о Data Science
14 Apr 2025, 21:15
🤖 TidyBot++: применение, статья, кодРебята написали довольно хороший абстракт с документацией для своего проекта, можно хорошенько залипнуть на целый вечер (и собрать своего робота)Вот они, слева направо: сайт, статья, GitHub@notedatascienceБлог о Data Science
4 Apr 2025, 15:13
⌨️ Change of plans: OpenAI editionАльтман написал, что o3 и o4-mini выйдут через пару недель, а GPT-5 – через несколько месяцевИ это после объявлении об их промо-кампании по раздаче подписок Plus американским и канадским студентам. Выпросили!Стоит ли ждать релиза за день до LlamaCon, то есть 28 апреля? 😭@notedatascience
Блог о Data Science
23 Jan 2025, 18:01edited
🧿 Live: Introduction to Operator & AgentsТолько что началась трансляция на YouTube канале OpenAI про фичу оператора.Трансляция: https://www.youtube.com/watch?v=CSE77wAdDLgСтатья: https://openai.com/index/computer-using-agent/Reddit: https://www.reddit.com/r/singularity/comments/1i88v45/introduction_to_operator_agents/@notedatascienceYouTubeIntroduction to Operator & AgentsBegins at 10am PT Join Sam Altman, Yash Kumar, Casey Chu, and Reiichiro Nakano as they introduce and demo Operator.Блог о Data Science
27 Dec 2024, 19:01
📸 Paragraphica: context-to-image cameraНедавно наткнулся на один интересный арт-проект. Paragraphica — это камера, которая использует данные о местоположении и другие показатели для генерации "фото" места и момента. Вот ключевые моменты:🖍️Принцип работы: камера анализирует данные о местоположении — адрес, погоду, время суток и близлежащие объекты. На основе этих данных она генерирует текстовое описание текущего места.🖍️Технология: с помощью AI image synthesis, текстовое описание преобразуется в визуальное изображение. Это не обычное фото, а визуализация данных, отражающая сущность момента и место, в котором вы находитесь.🖍️ Оборудование: Raspberry Pi 4, 15-дюймовый сенсорный экран, 3D-печатный корпус, индивидуальная электроника.Блог о Data Science
21 Dec 2024, 19:15
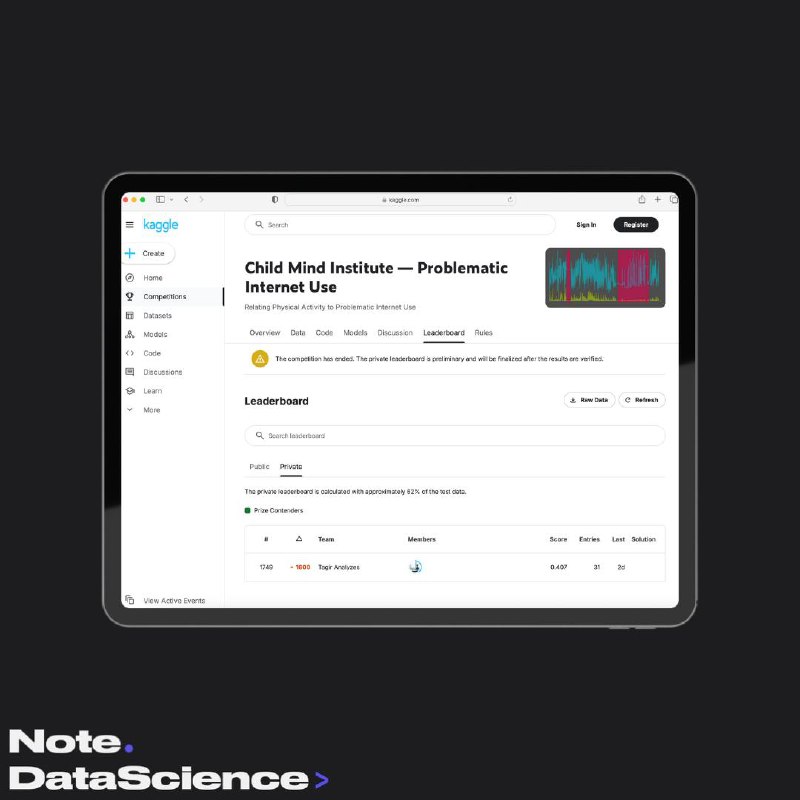
😃 Kaggle x Child Mind Institute: произошел шейкапПару дней назад подвели результаты Kaggle соревнования Child Mind Institute – Problematic Internet Use. Задача – предсказать уровень проблемного использования интернета детьми и подростками, основываясь на их физической активности 😡Здесь мог бы быть пост о том, как я заслал паблик решение и (чудом) получил серебряную медальку, но получилось еще интереснее: произошел жесткий шейкап. Никогда ведь такого не было – вот тут дискуссия с подобными случаями за 2024 год 🤡Средний шейкап у людей с призовых мест получился +1750 позиций, а на 2 месте так вовсе есть зеленый гусь из Индии с 2 саббмитами, который по приколу залетел в сореву, отправил пару решений и забил за пару месяцев до конца соревнования 🔘Реше
Блог о Data Science
20 Nov 2024, 21:58
🤝 Результаты эксперимента «AI Art Turing Test»В блоге Astral Codex Ten недавно опубликовали результаты эксперимента «AI Art Turing Test». Участникам предлагалось отличить произведения искусства, созданные человеком, от изображений, сгенерированных искусственным интеллектомВот некоторые цифры из результатов:🤝 Средняя точность ответов участников составила примерно 60% 🤝 Только около 5% участников смогли правильно идентифицировать более 75% изображений. 🤝 Примерно 25% участников показали точность ниже 50% 🤝 Некоторые изображения вводили в заблуждение особенно часто: одно из AI generated изображений было идентифицировано как человеческое более чем в 70% случаев.Подробнее об эксперименте и его выводах можно узнать в
Блог о Data Science
25 Oct 2024, 14:06
🎵 Как Spotify ускорил разметку данных для ML в 10 разSpotify недавно рассказал, как они ускорили разметку данных для ML-моделей в 10 раз. Главный секрет — использование LLM в сочетании с работой аннотаторов. Модели берут на себя первичную разметку, а люди дорабатывают и проверяют сложные случаи, что дает трехкратный прирост производительностиВ стриминговом сервисе, который очень быстро растет, важно уметь создавать масштабируемые решения для снижения костов. Например, этот способ используется для выявления нарушений политики платформыИх стратегия разметки строится на трех столпах:⚡️ Масштабирование человеческой экспертизы: аннотаторы проверяют и уточняют результаты, чтобы повысить точность данных. ⚡️ Инструменты для аннотации: создание эффективных инструментов, которые упрощают
Блог о Data Science
30 Sept 2024, 07:01
📱 Illuminate by Google: paper to podcast serviceGoogle запустил в экспериментальном формате проект Illuminate – text-to-speech сервис, который превращает научные статьи по computer science в подкаст 🎧Сначала создаются краткие резюме статей и вопросы-ответы, а потом два сгенерированных AI-голоса — интервьюер и эксперт — разворачивают вокруг статьи короткое интервью (3-7 минут), объясняющее суть работы 🤫На сайте Google Illuminate уже можно послушать несколько примеров. Можно записаться в waitlist, чтобы получить доступ к самостоятельным генерациям. Я уже там как несколько недель, но доступа еще нет 🤗Вот несколько примеров генераций:⚡️Attention Is All You Need: audio, paper ⚡️Chain-
Related Channels
Other channels in the same section of the catalogue.