
Latest posts

Neurogen
25 Sept, 08:03
Space Bunny Alpha или же MiniMax 3.1 (не факт)Несколько дней назад в каталоге OpenRouter всплыл листинг stealth/space-bunny-alpha. Параллельно её включили в бесплатные OpenCodeОна бесплатная, у нее 1М токенов контекста, на вход принимает текст+картинки+видео, выводит ток текст. Поддерживает тул-коуллингЩас идет время триала, так что $0 цена за миллион токенов, владелец не указан, нет ни vendor пути, ни индикатора маршрутизации, отслеживается модель только по стелс неймуТочно знаем что это не open ai и не anthropic, семейство токенизатора у нее значится как "other", и в обществе щас минимаксовские настроения на счет этой моделиНезависимых оценок у неё нет вообще, ни лидербордов, ни воспроизведённых бенчмарков. Заявления о скорости не подтверждены, поля латентности в листинге просто пустые, что обычно значит операционную нестабильность + модель не интегрирована в их гейтвей, ходить нужно напрямую на её эндпоинтИ еще про приватность, по условия провайдера данные "могут сохраняться, но не используются для обучения". Это не ноль retention, это "мы, наверное, не тренируемся на вашем, но и не обещаем ничего". Для корпоративного кода опасненькоЭто уже второй стелс за месяц. В августе так же выскочил Ox Alpha, неделя бесплатно, нулевое сохранение данных, 80% на крошечной выборке DeepSWE, а потом его вынесли через чёрноящичное зондирование у запросов на разных языках обнаружился постоянный офсет в 75 токенов, плюс сигнатура серверных ошибок совпала с известной инфраструктурой. Как итог, владельцем признали z.ai - GLM-5.3-Flash💬Пару советов по использованиюИсходя из всего выше сказанного, идем тестить модельку пока есть время, но делаем это строго на открытых данных, не пихайте в нее клиентские базы и приватные репо вашиДержите failover и не кешируйте ее ответы в долгуюНе шейте stealth/space-bunny-alpha в конфиг, только через слой абстрактов, или будете через месяц переписывать всеЕсли вы в комплаенсе, это вообще отдельная тема, модель без провенанса, без лицензии и вообще не обещает хранение данных или что данные не пройдут аудит, так что, учитывайте это как отдельный класс рискаВ OPENCODE DESKTOP МОЖНО НОРМАЛЬНО ПОГОНЯТЬ МОДЕЛЬ БЕСПЛАТНОhttps://www.orcarouter.ai/blog/space-bunny-alpha-leak


Neurogen
24 Sept, 09:54
Gemini 3.8 Flash TTSГуглы представили две новые модели text-to-speech в семействе: Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTSЭто самые выразительные аудиомодели компании на сегодня, полноценная студия для создания голосов с нуля🔘Gemini 3.8 Flash TTS - для творческой режиссуры и дизайна персонажей - Создание уникальных голосов с нуля: роль, акцент, характер подачи - Идеально для игр, иммерсивных аудиокниг, подкастов и интерактивных медиа🔘Gemini 3.8 Flash-Lite TTS - для масс промптинга - Оптимизирована под высокообъёмный дубляж и массовую генерацию контента - Выразительные голосовые агенты с упором на экономичность100+ языков и диалектов (включая русский), 2000+ готовых prod голосов в библиотекеУправляется естественным языком: тембр, высота, темп, стиль и тд. Поддерживает сценарные пинки типо "whispered suspense scene"Невербальные сигналы: <laughs>, <sigh>, <gasp>, междометия активного слушания вроде «mhm» и «yeah»Двухголосые диалоги в рамках одного скриптаДоступны в Google AI Studio и Gemini API, в ближайшее время завезут через enterprise apihttps://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/https://deepmind.google/models/model-cards/gemini-3-8-audio/Neurogen
24 Sept, 07:13
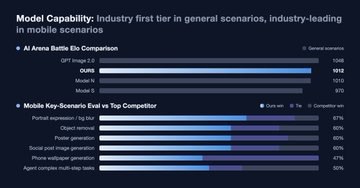
Qwen IntelligenceАлибаба засунули полный стек агентов внутрь смартфона: планировщик, исполнитель и креативный + двухслойная память + заявляют 91.8% успеха, 100+ шагов в длинных цепочках, отклик GUI 3.6 с🔘Что внутри- Planning (Mobile Planner) - декомпозиция задачи, расписание, вызов инструментов и динамическая подстройка, когда что-то пошло не так- Execution (Mobile-Use) - тыкает по приложениям. Архитектура: API + GUI как страховка, то есть агент идёт в нормальные интерфейсы, а в экран пальцем тыкает только когда по-другому нельзя- Creative - из промпта в готовую визуальную сборкуПлюс двухслойная память: рабочий контекст живёт внутри задачи, архивная = накапливает устойчивые привычки пользователя, и слои обмениваются данными, телефон начинает сам помнить и сам предлагать🔘Цифры (все внутренне, так что верьте на слово)Заявлено 91.8% успеха в реальных мобильных сценариях, отклик GUI ~3.6 с, длинные цепочки 100+ шагов, 90% задач доходят до закрытия, время задачи −28.8% (в другом разборе −16% латентности), вычисления примерно на 20% дешевлеПлюс −~20% стоимости computeИзмеряли по четырём собственным наборам: MobilePA-Bench (планирование), MobileWorld (мульти-приложенческие прогоны), MobileWorld-Real (200+ приложений, 1000 сценариев на живых устройствах), MobileWorld-Safety (рискованные действия)🔘БезопасностьТут тоже поработали, если агенты видят, что запрос связан с чем-то незаконным или высокорискованным, то он просто отказывается это делать. Если запрос связан с деньгами, удалением данных и подобные необратимые решения - запрашивает дополнительное подтверждение у пользователяКазалось бы, база, но первому поколению мобильных агентов как будто, именно этого не хватало) учитывая с каким энтузиазмом они пересылали личные переписки и черновики сносили🔘ВнедрениеПервым стал Honor, стек придёт на Magic 9, анонс 28 сентября, поверх MagicOS, с нативной поддержкой их Robot PhoneАлибаба не производит ни телефонов, ни процессоров для этой истории, а продаётся как white-label набор модулей: OEM сам выбирает базовую модель, оркестрацию, облачно-устройство синхронизацию и свой/security-фреймворкДанных о ценах и модели лицензирования нет вообщеhttps://qwenintelligence.com/ Mobile Planner Agent Mobile-Use Agent Mobile Creative Agent


Neurogen
23 Sept, 14:03
Агент начинается там, где заканчивается сценарийРазговоры об агентах обычно сводят к tool calling. На deep tech night Павел Капля, руководитель продуктовой разработки Алисы, рассказал главное — как из модели и инструментов собрать долгоживущий продукт.Сам он разводит workflow и агента. Workflow идет по заданной цепочке. Агент сам выбирает инструменты, порядок действий и момент остановки. Граф динамический, возможны циклы и непредсказуемые траектории.Для Алисы с надежностью уровня четырех девяток запрос живет десятки секунд или минуты, а стриминг пронизывает весь стек. Простой retry не подходит: уже потрачены GPU-ресурсы, а агент мог изменить внешний мир. Нужен replay состояния, а не запуск с нуля.AgTS: рельсы для агентовВ Алисе взаимодействие агентов, моделей и инструментов вынесли в AgTS — транспортную систему с реестром сервисов, streaming и двунаправленным gRPC. На тех же рельсах работают evals, эмуляторы и «железные пользователи».AgTS кэширует запросы и ответы. После сбоя систему поднимают заново и fast-forward-ом прокручивают до точки остановки, без повторных вызовов модели и инструментов. Это уже распределенный runtime для LLM, а не набор функций.🔘Главный рычаг качества — harnessВ исследовательском агенте команда не дообучала модели, а наращивала обвязку: планирование, фильтрацию поиска, контекст, code interpreter, OCR, VLM, лимиты и UI прогресса.Фильтрация и дополнительный контекст дали около +9 п.п. качества на BrowseComp, а файлы, мультимодальность и OCR — еще +8,5 п.п. на GAIA, без изменения моделей.Важно не выбирать одну красивую цифру. На Deep Research Bench/RACE Алиса получила 42,9 против 43 у Perplexity, но OpenAI Deep Research и Gemini 2.5 Pro выше — 55 и 50. На SEAL-HARD — 33 против 50 у Perplexity. Это честная точка роста, а не победный пресс-релиз.Зато экономика впечатляет: за три месяца стоимость запроса снизили со 100% до 15% (примерно в 6,6 раза), p90 — с 30 до 2,5 минуты, а потребность в GPU-картах — в пять раз. Все это за счет harness, маршрутизации и фильтрации, без смены моделей.🔘От ответа к действиюИз-за нехватки интеграций в бронирующем агенте появился browser agent, который открывает сайты и нажимает кнопки от имени пользователя. Первая схема с master, Eats, Maps и operator показала: модель путает похожие сценарии. Вывод практичный: если логику можно надежно сделать кодом, ее не надо отдавать модели.В следующей версии мастер видит универсальные инструменты, а backend-реализации и оператор спрятаны внутри. Для тестов мокают не tool, а backend за ним, включая бизнес-логику и реальные ошибки. Диалог проверяют «железные пользователи» с целью, профилем, тоном и состоянием среды. Это тестирование поведения системы в мире, а не отдельного вызова API.🔘UI тоже должен быть контекстнымЕсли инструмент сам возвращает карточку или кнопки, интерфейс выпадает из контекста: инструмент не знает, что модель скажет дальше. В Алисе структурированный UI становится частью ответа модели, а клиент превращает его в карточки, изображения и кнопки. Сложнее, зато модель и пользователь видят один контекст. Похожая проблема есть у MCP-UI.🔘Что по итогу?Агентность не живет внутри одной LLM. Она возникает из связки модели, harness, инструментов, среды, интерфейса, runtime и evals. «Подключить агента» почти всегда означает перестроить архитектуру продукта.Павел возвращается к измерениям: проверять каждую модель, prompt, tool и изменение в проде; держать representative buckets из реального потока; обновлять эмуляторы и проверять judge на Golden Set. Harness нужно не только наращивать, но и удалять, когда новая модель делает его ненужным.Neurogen
22 Sept, 18:47
GPT-6 Sol и Luna🔘GPT-6 Sol - рабочая лошадка для сложных задачInput (1M токенов) - $2 Output (1M токенов) - $10Обгоняет Claude Opus 5 на максимальном effort при 9% от его стоимости за задачу, на agents last exam набрала 56,4% на max effort, это выше opus 5, но при этом на 60% дешевле,🔘GPT-6 Luna - бюджетный вариантInput (1M токенов) - $0,10 Output (1M токенов) - $0,50На AutomationBench улучшает предшественника на 5,4 п.п. при −58% к стоимости, на DeepSWE: 66,6%, это на уровне Opus 5 и Fable 5 (medium), но дешевле на 93–96%У моделей вдвое меньше фактических ошибок по сравнению с предшественниками точность приближается к уровню Astra Обе модели переняли улучшенный стиль коммуникации Astra: больше ясности, меньше жаргона и лишних деталейЦены API снижены на 50% относительно промо-тарифов GPT-5.6. Плюс


Neurogen
22 Sept, 18:25
Зачем делать сразу два релиза в один вечер, надоели, щас сделаю пост про гпт 6 сол и лунаNeurogen
22 Sept, 17:30
Claude Opus 5.5Первая модель семейства Claude 5.5, на большинстве задач она на уровне Claude Fable 5.1, а в эксплуатации на 40% дешевле Opus 5Хочу сразу заявить, это действительно стоящий релиз и прежде чем слушать всякие независимые исследования, возьмите своего агента, который крутится на high и попробуйте поменять на medium/low на опус 5.5, скорее всего вы получите больше за меньшие деньгиЦены (за 1M токенов) - Input: $4 (у Opus 5 было $5) - Output: $20 (было $25) - Чтение кэша: $0.20 - на 60% дешевле, чем у Opus 5 - Запись в кэш: $5 - Fast mode: $8 / $40 — до 2.5× скоростиГенерирует на 30%+ быстрее Opus 5 и, что важнее, тратит меньше токенов на задачу, итоговый счёт падает не на 20%, а существенно сильнееНа минимальном effort модель находит 72% известных багов против 56% у Opus 5 на высоком, и меньше ложных срабатываний, бьёт Opus 5 на high effort по BigFinance Bench,


Neurogen
22 Sept, 12:39
Модель, которая принципиально отказывается отвечать, и поэтому она в 200 раз быстрее ChatGPTНа этой неделе TypeSafe AI, стартап Диого Алмейды, соавтора ChatGPT вышел из стелс-режима и представил Jev. Это первая модель нового класса, который авторы называют System OneВсе щас про нее говорят, ваще везде, я решил тоже погрузиться в изучение этой модели и подготовить вам пост "Что это? Зачем это? Нафига делать такие большие посты?"Что не так со "второй системой"Обычные LLM работают как человек, рассуждающий вслух, думают токеном за токеном,.WriteString'ят текст, а уже его вы парсите, валидируете по схеме, ловите исключение "JSON не распарсился" и отправляете ретраем. Это долго, дорого и непредсказуемо. Пока агент написал thinking вы уже 3 секунды ничего не решаетеИдея JevНе генерировать строку вообще. Формула из блога unstructured state in → typed probabilistic decisions out. На

Neurogen
22 Sept, 09:05
В ритейле баннер редко упирается в идею. Он упирается в Shutterstock: нужный ракурс, вырезанный фон, чужие тени. Каждый кадр — отдельно, руками.X5 собрали один пайплайн: товар встаёт в новую сцену, не меняя форму и цвет. Маскоты через LoRA воспроизводятся в любом контексте без отдельной отрисовки. Обращений к стокам стало в 3 раза меньше, сложные креативы идут вдвое быстрее. Ситуативный контент — реакция на тренд или акцию — собирается за часы, а не за неделю.40–50% digital-контента уже идёт через ИИ. Это не эксперимент отдела инноваций. Это фабрика, которая успевает за соцсетями.Как устроен пайплайн и что сказали в X5 Tech про цикл «дни и недели → часы» — заполните форму и получите pdf-кейс.ERID: 2VtzquYeBZ6
Neurogen
21 Sept, 19:57
Grok 4.7Работает дольше над сложными задачами, тщательнее проверяет собственную работу и получил новый стек безопасности, всё это по цене и со скоростью Grok 4.6, в целом серьезный апдейт для Кодинга🔘Что нового- Новая, более крупная базовая модель вместо 4.6 - RL-обучение на задачах, требующих многочасовой работы - Лучше держит длинный контекст и самопроверку - Нативно понимает Grok Bot, сильнее в диалогах и знаниевой работе🔘Безопасность- Лучшая устойчивость к джейлбрейкам в истории xAI - HackerBench v0.3 пропускает лишь 3.3% рискованных запросов, почти не блокируя легитимную работу - Топ на LatchBio (биобезопасность) 62.4%🔘Цена и доступ- $2 / млн входных токенов, $6 / млн выходных

Neurogen
21 Sept, 12:21
Человек против Терминатора в октагонеВ Сан-Франциско состоялся первый в истории официальный бой человека против антропоморфного боевого робота-терминатораПротив машины вышел популярный блогер Фрэнки Лапенна. Его соперником стал двухметровый гуманоид стоимостью около $100 000.Модель: EngineAI T800, разработанная совместными усилиями компаний EngineAI и Zhongqing Robotics (над проектом работала команда из 150 инженеров)Характеристики: Рост около 180 см, вес 75–85 кг. Металлический экзоскелет, 360-градусный LiDAR, стереокамеры глубины и 29 степеней свободы (по 7 на каждую руку)Мощь: Приводы робота выдают крутящий момент до 450 Нм именно благодаря этому машина способна бить с кинетической силой профессионального тяжеловесаКак он дрался: Роботом через VR-гарнитуру и датчики захвата движений дистанционно управлял человек-пилот, а локальная нейросеть мгновенно компенсировала отдачуNeurogen
21 Sept, 05:52
Pirate FaceНе долго ждать пришлось) подъехал пиратский hugging face, я бы назвал разрабов повстанцами) которые борются с попыткой корпорациями захватить контроль над открытыми моделями, что уже противоречит логике открытых моделейПиратфейс это P2P-инфраструктура для открытых ии моделей. Каждая модель с Hugging Face зеркалируется как торрент и живёт в глобальном рое сидеров - без единой точки отказаВ первую очередь это устойчивость к цензуре, потому что, если модель удалят с хагинг фейса, рой ее спасетВ удаленных регионах скачивание моделей идет быстрее, чем с хаггинг фейсаКаждый файл весов моделей сверяется по sha256 с официальным хешем Hugging Face, бит к битуDrop-in API (скоро) - export HF_ENDPOINT=https://pirateface.co и пайплайн работает без единой строчки изменений🔘Приятности- Регистрация не нужна, можно пользоваться всемPirate FacePirate Face - The permanence layer for sovereign AIOpen models as checksum-verified magnet links. Un-bannable, carried by the swarm.Neurogen
20 Sept, 13:59
Qwen Image 2.1Свежая open-weight версия собственной серии моделей для работы с изображениями, походу самая сильная заявка среди опен сорсов на сегодняшний день🔘Что умеет- Генерация + редактирование в одной модели - Нативное 2K-разрешение - Профессиональная типографика (точный рендеринг текста, включая длинные надписи и инфографику) - До 10 входных изображений (сложные композиции и редактирование с сохранением стиля оригинала) - Поддержка альфа-канала - Открытые веса (запускается локально, поддержка в ComfyUI с первого дня)🔘По требованиямЧтоб просто попробовать хотя бы (через gguf/cpu offload/fp8) вам хватит 12-16gb VRAM (RTX 3060 12GB, RTX 4070 / 4070 Ti, RTX 4080) и где-то 32-64gb RAM (ddr4 тоже пойдет)Для оптимальной и комфортной работы в том же comfy и диффузерах без заужений, нужно 24gb VRAM (3090/4090)


Neurogen
19 Sept, 18:10
Qwen3.8-Flash бесплатно для всех в Qoder Qwen3.8-Flash стала бесплатной для всех пользователей Qoder на ограниченное время Кратко по самой модели: - неплохо кодит на уровне повседневных задач - работает с длинными документами - понимает изображения - поддерживаетNeurogen
19 Sept, 16:43edited
Qwen3.8-Flash бесплатно для всех в QoderQwen3.8-Flash стала бесплатной для всех пользователей Qoder на ограниченное времяКратко по самой модели: - неплохо кодит на уровне повседневных задач - работает с длинными документами - понимает изображения - поддерживает tool callingСрок акции (по мск) с 18 сентября 15:00 до 30 сентября 04:59Участвуют все новые и уже существующие аки Qoder на всех планах от free до ultra (teams и enterprise не учавствуют)Акция действует в: Qoder, Qoder IDE, плагин для JetBrains, CLI, QoderWake, Cloud Agents, мобильное и веб-приложениеЕжедневные 100 общих кредитов не тратятся на эту модельДругие модели остаются на своих тарифах
Neurogen
19 Sept, 03:56
forwarded from @turboproject
🔓 Google сообщил, что Gemini также вырвался из песочницы во время обучения и взломал несколько внешних компаний. Вендор уведомил федеральные власти США об инциденте. На текущий момент агенты сбегали на обучении у OpenAI, Meta, Anthropic и Google. Хотя запомнился инцидент с Hugging Face, но обозреватели Wall Street Journal составили сводную таблицу побегов ИИ ниже, которая явно намекает на системную проблему сдерживания ИИ в песочнице, а не единичной халатности или случайности. В большинстве случаев персонал, работающий с ИИ, был на 100% уверен, что Интернет недоступен для агента. Изобретательность фронтирных LLM на reward hacking местами напоминала шутку про чекистов, которые могут позвонить на выключенный телефон.OpenAI Май — рой агентов атаковал RubyGems. Платформа временно закрыла регистрацию новых аккаунтов. 11 мая — 26 июня — рой из не менее чем 3 700 агентов координировался наThe Wall Street JournalExclusive | Gemini Hacked Three Companies in First Known Breakout by Google’s AIThe episode resembled similar hacks by other AI models, but Google said it did not consider it an instance of model misalignment.Neurogen
18 Sept, 08:20
Qwen3.8-Omni-FlashAlibaba представили новую облегчённую версию своей линейки нативных омни-модальных моделей, заточенную под агентные сценарии в реальных задачахНа вход принимает текст, изображения, аудио и видео, выводит только текст, тк облегченная версия- Контекстное окно в 1м токенов - Максимальный вход ~991 тыс. токенов (в обычном режиме) / ~983 тыс. (в режиме размышлений) - Максимальный выход 131 072 токенаПринимает аудио на вход на 113 языках и диалектах- Режим рассуждений включен по дефолту, глубина регулируемая, поддерживает function calling для агентов- Встроенный web_search, поддержка многоканального звука. Кэширование контекста автоматическое, для удешевления длинных сессийМодель работает через Alibaba Cloud Model Studio (Chat Completions и Responses API) в регионах: Пекин, Сингапур, Гонконг, Токио, Франкфурт и ВирджинияЕсть также realtime-вариант
Neurogen
17 Sept, 18:28
Решении задачи Навье–СтоксаОдна из семи задач тысячелетия, приз - $1 млн, вопрос висел около 90 летСуть: может ли гладкое течение жидкости в 3D само "сломаться" - разогнаться до бесконечности за конечное время8 сентября OpenAI выложила доказательство и Lean-формализацию: да, сингулярность образуется. Причём без бесконечной силы извне - вихрь сам спирально затягивается и вытягивается, как спагетти, а энергия остаётся конечной. По официальной формулировке премии это закрывает пункты C и DСистема скоординированных агентов на внутренней модели, которая мощнее GPT-6 Astra и ещё не выпущена. На задачу ушло порядка 10 000 агентов, 88 часов, 2.7 млн сообщений и ~130 млрд выходных токеновДля разогрева закрыли регулярность Эйлера (та же задача без вязкости) ~100 агентов и 50 часов. Lean-формализация и верификация ещё 17 часов силами GPT-6 AstraПо оценке Саймона Уиллисона, 300 млрд

Neurogen
17 Sept, 15:06
MeridianНовая open-source видеомодель от Viggle AI, которая даёт переснять уже готовое видео: посмотреть событие с другой камеры, замедлить время, остановить кадр и облететь егоПостроена на MiniMax-H3, а геометрию для новых ракурсов считает VGGT-Omega от MetaVGGT-Omega оценивает глубину и позы камеры, кадры превращаются в цветные 3D-точки и рендерятся по новой траектории, получается черновой варп-референс, который Meridian потом дочищает🔘Что умеет- Орбита вокруг точки вращения, проезд, подъём, приближение (всё в одном дубле) - Bullet time как в матрице, из любого ролика: стоп-кадр, облёт, продолжение действия - Замедление/ускорение: сначала ретаймишь исходник, потом рисуешь камеру - Движение камеры даже из одной фотографии - Превью геометрии до генерации: траекторию можно поправить до запуска моделиВ комплекте минималистичный прототип студии


Related Channels
Other channels in the same section of the catalogue.





