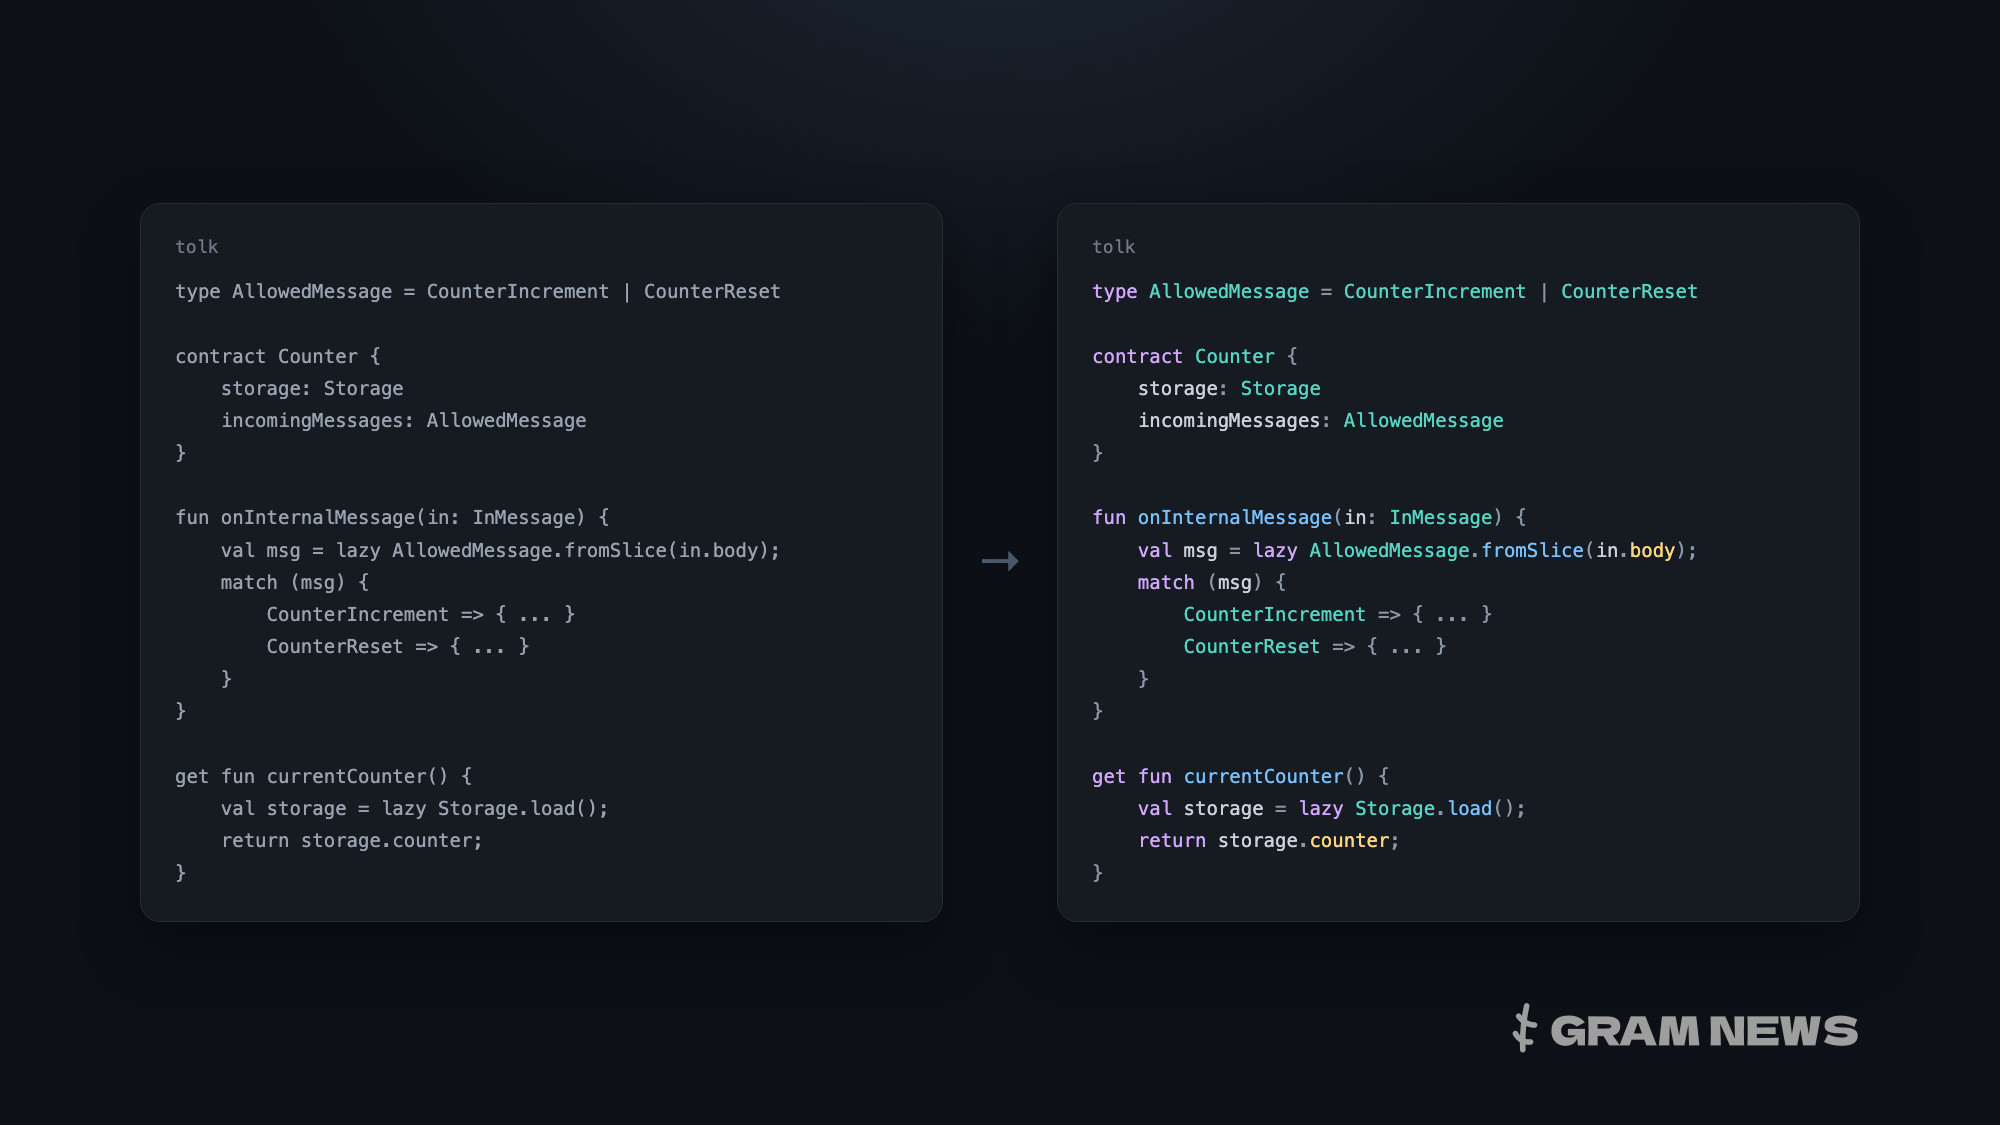
A primera hora del 21 de septiembre, en el repositorio libprisma — la biblioteca que Telegram usa para colorear bloques de código en los mensajes — se realizaron doce modificaciones en apenas tres horas. Se añadió Tolk, el lenguaje principal de contratos inteligentes en TON, se actualizaron las definiciones de Tact y FunC, y por primera vez desde el 20 de noviembre de 2023, se reconstruyó el archivo que leen las aplicaciones.
Por ahora, esto no es visible en las aplicaciones. Cada cliente lleva su propia copia de la tabla, y las tres versiones disponibles datan de 2023.
Cómo Telegram colorea el código
El análisis de bloques de código en los mensajes no lo realiza el servidor, sino el cliente mismo. A cargo de este proceso está libprisma, una adaptación en C++ de la biblioteca web Prism.js, lanzada por Telegram a finales de 2023. Las reglas de los lenguajes se generan a partir de dos fuentes: el paquete de Prism.js y varios archivos escritos directamente en el repositorio, desde donde se extraen los lenguajes de TON. Estas reglas pasan por una normalización y se combinan en un único archivo binario grammars.dat. El cliente carga este archivo al iniciar y luego consulta su contenido para obtener los tokens de cada bloque de código: qué partes son palabras clave, cadenas, comentarios, etc.
Este archivo es, en esencia, la lista completa de lenguajes soportados. Si un lenguaje no está en la tabla, el bloque permanece como texto monocromo gris, aunque el autor lo haya etiquetado correctamente como tolk tras tres comillas invertidas.
En Android, el funcionamiento es distinto: el motor Prism se ha reescrito en Java, y la tabla se almacena en un archivo propio, codelng.gzip, que llegó con la versión 10.2 a finales de octubre de 2023. Diferencias entre los motores de expresiones regulares — Boost en C++ y java.util.regex en Java — serán la principal causa de que se hayan realizado doce cambios en lugar de dos.
¿Por qué los lenguajes de TON siguen grises?
No es porque nadie haya escrito reglas para TON. Las definiciones de los cuatro lenguajes — Tact, FunC, Fift y TL-B — se integraron en los orígenes de libprisma en mayo de 2024. Cuatro meses después, se añadió una actualización: Tact pasó de la versión 1.2.0 a 1.6.0, y FunC se reescribió por completo, pasando de 0.2.0 a 0.4.4.
Ninguno de estos cambios llegó a las aplicaciones, y la culpa no está en ellas. Las reglas de los lenguajes viven en el repositorio como archivos comunes, pero los clientes leen una tabla binaria generada a partir de ellos. Y esta tabla se compiló por última vez el 20 de noviembre de 2023, seis meses antes de que se introdujera el primer lenguaje de TON en el repositorio. Todo lo añadido después permaneció en los orígenes sin ser distribuido.
La compilación se realiza mediante un flujo de trabajo en GitHub Actions, que dejó de ejecutarse por completo: GitHub retiró el uso de actions/upload-artifact@v3, y la tarea quedó marcada como fallida antes incluso de ejecutar su primer paso. Así, la actualización de Tact y FunC se quedó en cola durante dos años.
Tolk es una historia aparte. El lenguaje surgió como evolución de FunC y ahora figura en la documentación de TON como el recomendado, mientras que FunC se ha clasificado como obsoleto. Su inclusión en libprisma se propuso en mayo de 2026 y se mantuvo como borrador con la nota de que primero se debía decidir cómo desplegarlo en todos los clientes.
Lo que ocurrió el 21 de septiembre
En primer lugar, se arregló el proceso de compilación. Se actualizaron las versiones de las acciones, se reemplazó Node 18 por Node 22, y la tarea ahora se ejecuta de forma manual o automática cada vez que cambian las reglas de los lenguajes, generando un pull request con la tabla reconstruida. Tras esto, se aceptaron Tolk y las actualizaciones de Tact y FunC.
Durante la actualización se descubrió un error: FunC no se resaltaba completamente. La regla para operadores funcionales (_+_, _<=>_, etc., donde los guiones bajos indican posiciones de argumentos) se generaba a partir de otra regla, y finalizaba con una comprobación de «seguido por espacio». En forma compilada, esta verificación exigía un espacio exactamente en la posición donde debería estar el guión bajo de cierre, lo que hacía el requisito imposible de cumplir. Como resultado, la regla nunca se activaba.
Las demás modificaciones no están relacionadas con TON, pero explican por qué una sola tabla sirve para dos motores. Boost analiza expresiones por bytes y no entiende la notación \uXXXX: dentro de un conjunto de caracteres, esta secuencia se convierte en un conjunto arbitrario de caracteres ASCII. En el lenguaje Dhall, esto provocó que el conjunto de operadores devorara la primera letra de cada nombre de tipo, y el cuantificador ∀ no se resaltaba en ningún lenguaje donde apareciera. La serialización de la tabla cortaba el byte más significativo de los caracteres fuera del rango de los primeros 256, por lo que el símbolo • de BQN llegaba a la tabla como comillas dobles, ∞ como un carácter de control y π como la letra À.
La tercera corrección abordó una discrepancia entre motores. \v se compila de forma distinta en ambos: en uno representa un único carácter de tabulación vertical, en el otro, todo el conjunto de espacios verticales junto con el salto de línea. Esto hacía que los valores en archivos ini se salieran del final de su línea. Como la verificación de «¿se compila correctamente?» no detecta este problema, ahora se reconstruye la tabla para cada pull request y cada una de las casi cuatro mil expresiones se valida en ambos motores.
¿Cuándo lo verán en las aplicaciones?
No hay una fecha establecida en ninguno de los clientes. Las copias de la tabla no se descargan en tiempo real desde el repositorio, sino que se incluyen como parte del cliente, y cada copia es más antigua que el primer lenguaje de TON introducido en libprisma.
| Cliente | Origen de la tabla | Fecha de la copia |
|---|---|---|
| Telegram Desktop | fork de libprisma, incluido como submódulo | abril 2024, tabla interna: noviembre 2023 |
| Telegram para iOS | archivo grammars.dat en el repositorio del cliente | 31 de octubre de 2023 |
| Telegram para Android | archivo codelng.gzip en los recursos de la app | 28 de octubre de 2023 |
Actualizar la copia es decisión de cada equipo de desarrollo. En el borrador de Tolk se menciona explícitamente que el pull request esperaba una respuesta sobre cómo desplegar la nueva tabla en todas las aplicaciones. Mientras no llegue esa respuesta, los bloques etiquetados como tolk, tact o func seguirán mostrándose en los chats exactamente como lo hacían ayer.