صبح روز ۲۱ سپتامبر در مخزن libprisma — که تلگرام از آن برای رنگآمیزی بلوکهای کد در پیامها استفاده میکند — در عرض سه ساعت دوازده ویرایش انجام شد. در جدول زبانها، Tolk — زبان اصلی قراردادهای هوشمند TON — بهعنوان زبان جدید اضافه شد، تعریفهای Tact و FunC بهروزرسانی شدند و برای اولین بار از ۲۰ نوامبر ۲۰۲۳، فایل اصلی که برنامهها آن را میخوانند، دوباره ساخته شد.
این تغییرات هنوز در برنامهها دیده نشدهاند. هر کلاینت نسخهای از جدول را در خود دارد و هر سه نسخه — که همگی از سال ۲۰۲۳ هستند — همچنان بهروز نشدهاند.
چگونه تلگرام کد را رنگآمیزی میکند
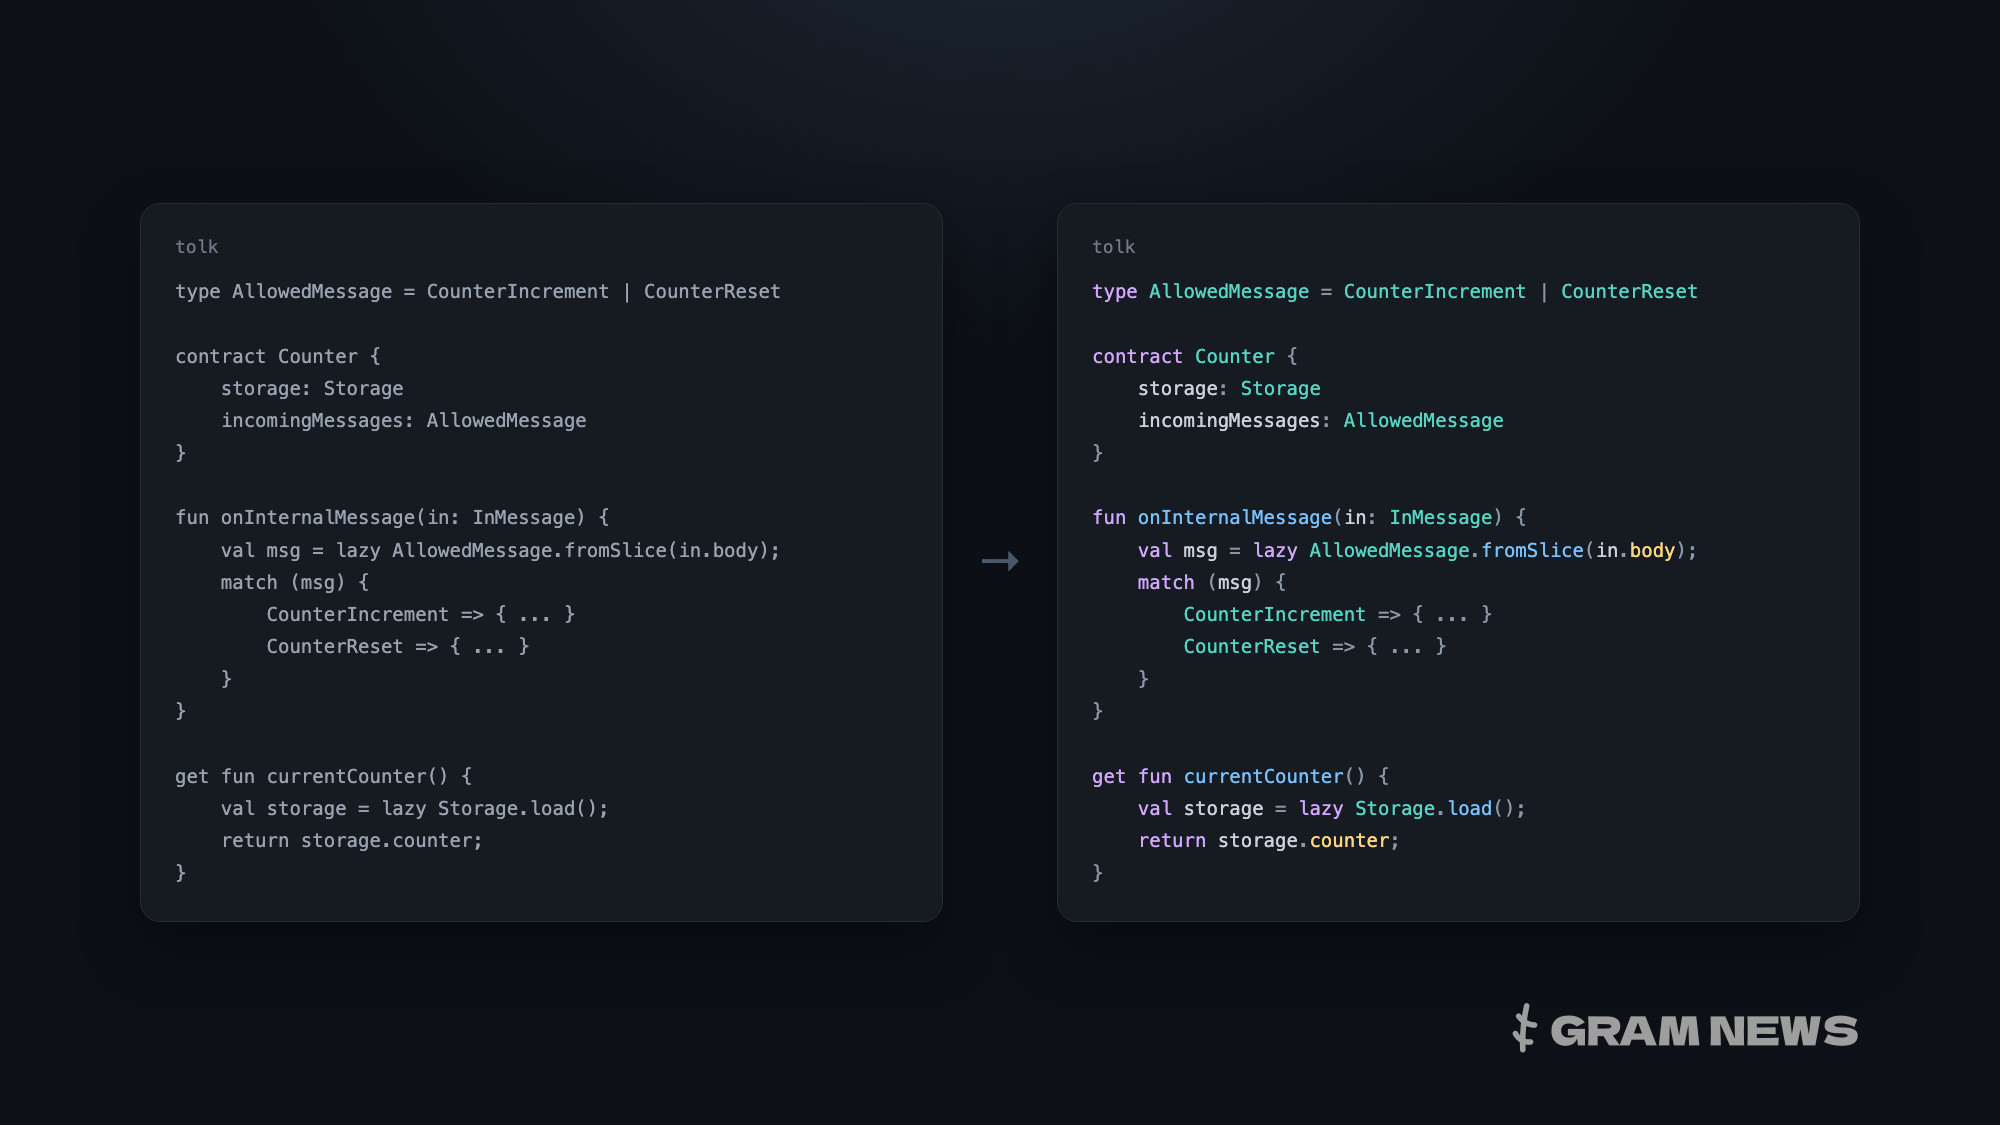
بلوک کد در پیام توسط خود کلاینت، نه سرور، تجزیه میشود. مسئولیت تجزیه را libprisma بر عهده دارد — کتابخانهای که تلگرام بهصورت انتقالیافته از Prism.js به C++ در پاییز ۲۰۲۳ منتشر کرده است. قوانین زبانها از دو منبع جمعآوری میشوند: از بسته Prism.js و از چند فایل مستقیم در مخزن که زبانهای TON را شامل میشوند. این قوانین پس از نرمالسازی ترکیب شده و در یک فایل باینری واحد به نام grammars.dat ذخیره میشوند. کلاینت این فایل را در هنگام راهاندازی بارگذاری میکند و سپس از آن برای دریافت تگهای مربوط به هر بلوک کد استفاده میکند — کجا کلمه کلیدی است، کجا رشته، و کجا کامنت.
این فایل باینری دقیقاً همان لیست تمام زبانهای پشتیبانیشده است. اگر زبانی در جدول وجود نداشته باشد، بلوک بهصورت متن خاکستری مونواسپیس نمایش داده میشود، حتی اگر نویسنده بهطور صریح آن را با tolk پس از سه گیومه باز علامتگذاری کرده باشد.
در اندروید، ساختار متفاوت است: موتور Prism در آن به زبان جاوا بازنویسی شده و جدول خود را دارد — codelng.gzip — که در پایان اکتبر ۲۰۲۳ با نسخه ۱۰.۲ وارد مخزن شد. تفاوت در موتورهای عبارتهای منظم — Boost در C++ و java.util.regex در جاوا — دلیل اصلی این است که تغییرات دوازدهتایی شدهاند، نه دو تایی.
چرا زبانهای TON هنوز خاکستری هستند
این زبانها خاکستری نیستند به این دلیل که هیچ قانونی برای آنها نوشته نشده است. تعریف چهار زبان — Tact، FunC، Fift و TL-B — در مخزن libprisma در ماه مه ۲۰۲۴ اضافه شدند. چهار ماه بعد، بهروزرسانی اعمال شد: Tact از نسخه ۱.۲.۰ به ۱.۶.۰ و FunC بهطور کامل از ۰.۲.۰ به ۰.۴.۴ ارتقا یافت.
اما هیچکدام از این تغییرات به کلاینتها نرسیدهاند و دلیل آن در خود کلاینتها نیست. قوانین زبانها بهصورت فایلهای معمولی در مخزن وجود دارند، اما کلاینتها از یک جدول باینری خوانده میشوند که از این فایلها ساخته شده است — و این جدول آخرین بار در ۲۰ نوامبر ۲۰۲۳ ساخته شده بود، یک نیمسال قبل از اینکه اولین زبان TON به مخزن وارد شود. هر چیزی که پس از آن اضافه شد، فقط در منابع باقی ماند و به هیچجا نرسید.
ساخت این جدول توسط workflow در GitHub Actions انجام میشود، اما از آن زمان بهطور کامل متوقف شده است: GitHub این اقدام را از کاربرد خارج کرد — actions/upload-artifact@v3 — و بههمین دلیل، وظیفه بهصورت خودکار از اولین مرحله هم اجرا نشد. بههمین دلیل، بهروزرسانی Tact و FunC دو سال در صف ماند.
Tolk داستان جداگانهای دارد. این زبان در سال ۲۰۲۶ بهعنوان توسعهای از FunC ظهور کرد و در مستندات TON بهعنوان زبان توصیهشده معرفی شده است، در حالی که FunC بهصورت رسمی بهعنوان منسوخ شده تلقی میشود. در libprisma، پیشنهاد اضافه کردن Tolk در مه ۲۰۲۶ ارائه شد و تاکنون در حالت پیشنویس با علامت مشخص شده بود که ابتدا باید تصمیم گرفت که چگونه این جدول جدید را در تمام کلاینتها توزیع کنند.
چه چیزی در ۲۱ سپتامبر اتفاق افتاد
اولین کار، رفع مشکل ساخت بود. نسخههای اقدامات بهروزرسانی شدند، Node ۱۸ با ۲۲ جایگزین شد و وظیفه دوباره فعال شد — بهصورت دستی و خودکار، هر زمان قوانین زبان تغییر کرد. پس از آن، Tolk و بهروزرسانی Tact و FunC پذیرفته شدند.
در حین بهروزرسانی، یک اشتباه پیدا شد که باعث شد FunC بهطور کامل رنگآمیزی نشود. قانون مربوط به عملگرهای تابعی (_+_, _<=>_ و سایری که خطکشها نشاندهنده مکانهای آرگومانها هستند) از یک قانون دیگر جمعآوری میشد، در حالی که در نهایت بررسی «فضای خالی بعد از آن» انجام میشد. در حالت باینری، این بررسی نیازمند یک فاصله دقیقاً در موقعیتی بود که باید نشانه بستهشده خطکش قرار داشت — شرطی که هرگز امکانپذیر نبود، بنابراین قانون هرگز اعمال نشد.
سایر ویرایشها مربوط به زبانهای غیرTON هستند، اما توضیح میدهند چرا یک جدول میتواند بهطور همزمان برای دو موتور کار کند. Boost عبارتهای منظم را بهصورت بایتها میخواند و نمیتواند نوشتههایی مانند \uXXXX را درک کند: درون کلاسهای کاراکتری، چنین نوشتهای به مجموعهای از کاراکترهای ASCII تبدیل میشود. در زبان Dhall به همین دلیل، کلاس عملگرها اولین حرف هر نام نوع را میخورد، و کوانتور ∀ در هیچ زبانی که به آن اشاره شده بود، رنگآمیزی نشد. سریالسازی جدول بایت اولیه کاراکترهای خارج از ۲۵۶ اول را حذف میکرد، بههمین دلیل کاراکتر BQN • در جدول به دو گیومه، ∞ به عنوان کاراکتر کنترلی و π به عنوان حرف À وارد میشد.
ویرایش سوم مربوط به تفاوت موتورهاست. \v در هر دو موتور کامپایل میشود، اما معنای متفاوتی دارد: در یکی یک کاراکتر تب عمودی است، در دیگری کلاسی از فاصلههای عمودی بههمراه خط جدید. بههمین دلیل، مقادیر در فایلهای ini از انتهای خط خارج میشدند. بررسی «آیا کامپایل میشود» این مشکل را تشخیص نمیدهد، بنابراین اکنون برای هر PR، جدول دوباره ساخته میشود و هر یک از تقریباً چهار هزار عبارت از طریق هر دو موتور گذرانده میشود.
این تغییرات چه زمانی در کلاینتها دیده میشود
هیچ یک از کلاینتها تاریخ مشخصی برای اعمال این تغییرات تعیین نکردهاند. کلاینتها جدول را از مخزن بهصورت آنلاین دریافت نمیکنند، بلکه نسخهای از آن را در خود حمل میکنند، و هر نسخه از این جدول از اولین زبان TON در libprisma پیشتر است.
| کلاینت | منبع جدول | تاریخ نسخه |
|---|---|---|
| تلگرام دسکتاپ | فورک libprisma که بهعنوان زیرماژول قفل شده است | آوریل ۲۰۲۴، جدول درونی — نوامبر ۲۰۲۳ |
| تلگرام برای iOS | فایل grammars.dat در خود مخزن کلاینت | ۳۱ اکتبر ۲۰۲۳ |
| تلگرام برای اندروید | فایل codelng.gzip در منابع برنامه | ۲۸ اکتبر ۲۰۲۳ |
بهروزرسانی نسخه جدول، تصمیمی است که هر تیم کلاینت باید بگیرد، و در پیشنویس Tolk بهوضوح ذکر شده است: PR در انتظار پاسخ است تا بدانند چگونه جدول جدید را در تمام برنامهها توزیع کنند. تا زمانی که پاسخی دریافت نشود، بلوکهایی که با tolk، tact یا func علامتگذاری شدهاند، در گفتگوها همانطور که دیروز بودند، نمایش داده میشوند.